SWIFT에서 Finternet까지, 국제 금융 인프라의 변화

금융 데이터를 빠르게 보내는 일과, 돈의 이전을 최종적으로 확정하는 일은 서로 다른 문제다.


국내에서는 계좌이체를 하면 몇 초 안에 상대방이 돈을 확인하는 경우가 많다. 그런데 해외송금에서는 수취까지 시간이 걸리고 중간 수수료나 환율 때문에 실제 도착 금액을 이해하기 어려울 때가 있다.


인터넷으로 정보는 즉시 전달되는데, 국경을 넘는 돈의 이동은 왜 복잡할까?

국제 금융에서는 메시지 전송 외에도 여러 기관의 장부 갱신, 통화 교환, 유동성 확보, 규제 확인이 연결돼야 한다. 시스템이 서로 연결돼 있다는 사실만으로 이 과정이 모두 동시에 끝나는 것은 아니다.


이번 글에서는 SWIFT와 기존 국제 금융의 구조를 살펴본 뒤, Finternet과 토큰화 기반 인프라가 무엇을 바꾸려는지 정리한다.

1. 메시지 vs 청산 vs 결제

해외송금을 이해하려면 ‘송금 처리’라는 표현 안에 여러 단계가 있다는 점부터 알아야 한다.


메시지 전달 지급 지시와 관련 정보 교환 누구에게 얼마를 지급하라는 요청인가?
청산(Clearing) 지시 확인, 대사, 결제할 의무 산정 등 각 기관이 무엇을 주고받아야 하는가?
결제(Settlement) 자금 등의 이전으로 의무 이행 실제로 의무가 이행됐는가?
결제완결성(Finality) 이전이 최종적이고 취소 불가능하게 확정 언제부터 최종 결과로 인정하는가?

표는 개념을 단순화한 것이다. 실제 시스템에서는 일부 단계가 통합되거나 서로 다른 방식으로 구현된다.

특히 결제완결성은 화면에 ‘성공’이라고 표시하는 것보다 넓은 개념이다. 시스템의 규칙과 법적 기반까지 연결된다. 금융시장인프라 원칙도 명확한 결제완결성과 법적 근거를 중요하게 다룬다. CPMI-IOSCO 금융시장인프라 원칙


따라서 다음 상태는 구분해서 봐야 한다.

요청을 접수했다
      ↓
지급 메시지를 전달했다
      ↓
기관 간 의무가 결제됐다
      ↓
수취인이 자금을 이용할 수 있다

모든 거래가 정확히 이 순서로 진행되는 것은 아니지만 각 상태가 가리키는 대상은 다르다.

2. SWIFT는 국제 금융에서 어떤 역할을 할까?

SWIFT는 은행과 금융기관 등이 금융거래 관련 메시지를 안전하고 표준화된 방식으로 교환하는 네트워크다.

기존 SWIFT 메시징의 중심 역할은 지급 지시와 금융정보를 전달하는 것이다. SWIFT 공식 설명도 실제 자금 이전은 은행 등 관련 기관을 통해 이루어진다고 구분한다. SWIFT 공식 소개


가상의 예시로 표현하면 다음과 같다.

한국 기업
   ↓ 지급 요청
한국 은행
   ↓ 금융 메시지 교환
관련 금융기관
   ↓
해외 수취 은행
   ↓
해외 거래처

메시지가 전달되는 동안 관련 기관들은 각자의 계좌와 장부를 갱신하고 필요한 절차를 수행한다. 메시지 경로와 실제 결제 경로가 항상 단순한 일대일 관계인 것도 아니다.

SWIFT는 수취 은행에 지급이 도달한 시점과 최종 고객 계좌에 입금되는 시점 사이에서도 지연이 발생할 수 있다고 설명한다. 따라서 네트워크의 전달 속도와 사용자가 체감하는 전체 소요시간을 구분해야 한다. SWIFT의 지급 처리 설명

이후 살펴보겠지만 SWIFT도 기존 메시징에 더해 공유원장 기반 기능을 개발하고 있다.

3. 해외송금에서는 왜 여러 은행이 등장할까?

모든 은행이 세계의 모든 통화와 지급결제 시스템에 직접 참여하기는 어렵다.

그래서 다른 은행과 관계를 맺고 계좌와 서비스를 이용하는 환거래은행(Correspondent Banking) 구조를 활용한다.


예를 들어 한국 은행이 외국 은행에 보유한 외화 계좌를 통해 지급을 처리할 수 있다.

이때 자주 등장하는 용어가 다음과 같다.

Nostro 계좌 우리 은행이 다른 은행에 보유한 계좌
Vostro 계좌 다른 은행이 우리 은행에 보유한 계좌

같은 계좌를 어느 은행의 입장에서 보느냐에 따라 표현이 달라질 수 있다.

국경을 넘는 지급은 이런 계좌 관계와 각국의 지급결제 시스템을 조합해 처리된다. BIS도 환거래은행 구조에서 외환 교환, 사전 자금 확보, 시스템 간 상호운용성을 주요 과제로 설명한다. BIS: Payments without borders

유동성을 미리 준비하는 비용

은행이 필요한 통화의 지급을 처리하려면 사용할 수 있는 자금이 있어야 한다.

관련 계좌에 미리 잔액을 확보하면 지급 실패 가능성을 줄일 수 있지만 여러 곳에 자금이 묶이는 비용이 발생한다. 다른 은행이 신용을 제공하는 구조라면 그에 따른 위험도 고려해야 한다. BIS의 국경 간 유동성 설명

빠른 메시징만으로 해결하기 어려운 부분이다.

4. 국제 지급의 지연은 어디서 발생할까?

국제 지급에서는 여러 종류의 마찰이 겹친다.

요인 발생할 수 있는 문제
통화 차이 환율 결정과 외화 유동성 확보
운영시간 차이 국가별 영업일·결제시간 불일치
데이터 차이 정보 누락, 형식 변환, 추가 확인
규제 차이 관할별 확인 사항과 제한 검토
기관 간 연결 여러 시스템의 상태와 결과 조정

연방준비제도의 국경 간 지급 설명도 통화, 시간대, 규제 차이와 환거래은행 관계, 유동성 문제를 주요 과제로 다룬다. Federal Reserve: Cross-Border Payments


여기서 IT 관점의 핵심은 여러 기관이 각자 관리하는 상태를 일관되게 맞추는 일이다.

한 기관에서는 처리가 끝났는데 다음 기관에서 정보가 부족할 수 있다. 지급 지시는 유효하지만 결제할 자금이 준비되지 않았을 수도 있다.

이 문제를 개선하는 방향은 다음처럼 나눌 수 있다.

  • 기관들이 더 정확한 데이터를 교환하도록 한다.
  • 기존 지급 시스템의 연결과 운영 방식을 개선한다.
  • 여러 자산과 결제 단계를 함께 처리할 새로운 구조를 만든다.

ISO 20022, 지급 시스템 연계, 토큰화와 공유원장은 각각 이 중 일부를 다룬다.

5. ISO 20022는 금융 메시지의 공통 언어다

ISO 20022는 금융정보를 공통된 의미와 구조로 모델링하고 메시지를 정의하는 국제 표준 체계다.

단순히 파일 확장자를 바꾸는 작업으로 보기보다는, 금융기관이 교환하는 데이터의 의미를 맞추는 기반으로 이해하는 편이 좋다. ISO 20022 공식 FAQ

예를 들어 지급 관련 정보를 구분된 항목으로 다루면 다음 업무를 지원할 수 있다.

  • 송금인과 수취인 정보 처리
  • 지급 목적과 참조정보 연결
  • 자동 대사
  • 규제 확인과 예외 처리

하지만 형식이 같다고 데이터 품질까지 보장되지는 않는다. 같은 필드라도 입력 기준과 사용 규칙이 맞아야 한다.

SWIFT의 관련 전환에서는 2025년 11월 22일 CBPR+ 지급지시 메시지의 MT·ISO 20022 공존 기간이 종료됐다. 이를 모든 금융 메시지와 전 세계 시스템이 같은 날 일괄 전환됐다는 의미로 확대해서는 안 된다. SWIFT ISO 20022 구현 안내

이 표준의 역할은 정보를 더 잘 교환하도록 돕는 것이다. 그 자체가 결제 자산이나 새로운 지급 네트워크는 아니다.

6. Finternet은 무엇일까?

Finternet은 여러 금융 생태계를 인터넷처럼 상호 연결하자는 미래 금융 시스템의 비전이다.

Agustín Carstens와 Nandan Nilekani가 2024년 BIS 워킹페이퍼에서 제안했다. 특정 제품이나 이미 전 세계에서 운영되는 단일 네트워크의 이름으로 읽으면 부정확하다. Finternet 원문

구상의 중심에는 사용자가 금융기관과 자산 종류 사이의 장벽을 덜 느끼면서 금융서비스를 이용하도록 하자는 목표가 있다.


이를 위해 원문은 다음 기반을 함께 다룬다.

  • 경제, 금융 구조
  • 토큰화 등 디지털 기술
  • 법률, 규제, 거버넌스
  • 상호운용성, 검증 가능성, 보안과 개인정보 보호

즉, 기술적인 연결만으로 완성되는 구상이 아니다.

예를 들어 다른 기관에 있는 자산을 담보로 사용하면서 대출과 결제를 연계하려면, 데이터와 자산 이전뿐 아니라 권리의 유효성, 담보 집행, 참여기관의 책임도 정해져야 한다.

또한 해당 워킹페이퍼의 견해는 저자들의 것이며, BIS나 회원 중앙은행 전체의 공식 입장을 반드시 뜻하지는 않는다. BIS 워킹페이퍼 설명

7. 토큰화는 기존 디지털 장부와 무엇이 다를까?

은행 예금과 증권은 이미 전산 장부로 관리된다.

그렇다면 토큰화가 추가로 제공하려는 기능은 무엇일까?

BIS는 토큰화를 기존 장부에 있는 실물·금융자산에 대한 권리를 프로그래밍 가능한 플랫폼에 기록하는 과정으로 설명한다. 이를 통해 메시지, 대사, 자산 이전을 더 긴밀하게 결합하는 가능성을 제시한다. BIS: 차세대 통화·금융 시스템

예를 들어 증권 거래에서 다음 조건을 연계할 수 있다.

매수자의 지급 준비 확인
          +
매도자의 증권 이전 준비 확인
          ↓
연결된 조건을 충족하면 교환 실행

핵심은 자산을 표현한 데이터와 그 자산에 적용되는 처리 규칙을 같은 흐름으로 다룰 수 있다는 점이다.

다만 토큰을 발행했다는 사실만으로 현실의 권리가 새로 생기는 것은 아니다. 토큰이 어떤 청구권을 나타내며 누가 이행 책임을 지는지 정해져야 한다.

무엇이 토큰화됐는지도 중요하다

표현 대상 확인해야 할 내용
상업은행 예금 어느 은행에 대한 청구권인가?
중앙은행 준비금 어떤 참여자가 보유·이용할 수 있는가?
증권 어떤 법적 권리와 이전 절차를 나타내는가?
기타 지급 수단 발행자·상환 조건·보호 장치는 무엇인가?

이름에 ‘토큰’이 붙었다고 같은 위험과 법적 성격을 갖는 것은 아니다.

8. 통합원장에서는 무엇을 통합하려는 걸까?

Unified Ledger·통합원장은 토큰화된 자금과 자산, 관련 거래 규칙을 함께 처리할 수 있도록 하는 구상이다.

관련된 상태 변경을 조정해 여러 기관의 순차적인 확인과 대사 부담을 줄이려는 목적이 있다.


하지만 ‘통합’이 반드시 전 세계가 하나의 데이터베이스를 공유한다는 뜻은 아니다.

BIS는 단일 원장부터 서로 연결된 원장까지 여러 구조를 설명하며, 프로그래밍 가능성과 결합 가능성, 데이터·거버넌스의 독립성 사이에서 선택이 필요하다고 본다. BIS: 통합원장 아키텍처


예를 들어 국가별 데이터 보관 요건이 다르면 모든 정보를 한곳에 모으기 어려울 수 있다. 여러 원장을 연결하면 각자의 통제는 유지하기 쉽지만, 원장 사이의 상태를 맞추는 작업이 복잡해진다.


따라서 “원장을 합치면 해결된다”보다 다음 질문이 먼저다.

어떤 상태를 함께 확정해야 하고, 어떤 정보와 통제는 분리해야 할까?

9. 원자적 결제는 무엇을 해결할까?

원자성·Atomicity는 연결된 작업을 모두 실행하거나, 모두 실행하지 않는 방식으로 다루는 성질이다.

외환 거래를 생각하면 의미가 분명해진다.

거래 당사자 A의 통화 지급
             ↕ 조건 연결
거래 당사자 B의 다른 통화 지급

한쪽 지급만 최종 완료되고 반대쪽 지급이 실패하는 위험을 줄이려면 두 이전을 연결해야 한다.

이와 관련된 대표 개념이 다음과 같다.

  • PvP·Payment versus Payment: 서로 다른 통화의 지급을 연결
  • DvP·Delivery versus Payment: 증권 등의 인도와 대금 지급을 연결

금융시장인프라 원칙도 연결된 의무의 최종 결제가 조건부로 함께 이루어지도록 하는 원칙을 다룬다. 이 접근은 기존 금융시장에서도 사용되며, 토큰화 플랫폼은 이를 구현·확장하는 방법을 연구한다. CPMI-IOSCO 금융시장인프라 원칙

원자성이 있더라도 유동성 부족, 잘못된 지시, 운영 장애까지 사라지는 것은 아니다. 어떤 작업 범위에 원자성을 적용했고, 외부 시스템과 법적 확정까지 어떻게 연결했는지 확인해야 한다.

10. 중앙은행 돈은 왜 계속 등장할까?

은행 계좌의 예금과 은행이 중앙은행에 보유한 준비금은 역할이 다르다.

상업은행 예금 고객이 상업은행에 갖는 청구권
중앙은행 준비금 상업은행 등이 중앙은행에 보유하는 결제 자산

은행 간 지급에서는 중앙은행 돈이 최종 결제의 기준 자산으로 중요한 역할을 한다. BIS와 중앙은행들의 공동 보고서도 기존의 이층 구조와 중앙은행 결제 자산이 통화에 대한 신뢰를 뒷받침한다고 설명한다. BIS: 기술혁신과 도매 중앙은행 돈

토큰화된 예금과 중앙은행 준비금을 함께 다루려는 프로젝트도 이 구조와 연결된다.

형태와 처리 방식은 바꾸되, 어떤 기관의 부채를 주고받으며 최종적으로 무엇으로 결제하는지 명확하게 하려는 것이다.

일반 사용자가 쓰는 소매형 CBDC와 금융기관 간 결제용 중앙은행 돈도 구분해야 한다. 도매 결제 실험이 곧 모든 국민을 위한 새 지갑 서비스의 도입을 뜻하지는 않는다.

11. 실제로 어디까지 진행됐을까?

Project Agorá: 다중통화 도매 지급 실험

Project Agorá는 BIS와 국제금융협회 IIF가 추진하는 민관 협력 프로젝트다.

토큰화된 상업은행 예금과 중앙은행 준비금을 공유된 프로그래밍 가능 플랫폼에서 결합해 국경 간 도매 지급을 개선할 수 있는지 살핀다.

공식 페이지에 따르면 2026년 7월 통제된 환경에서 실가치 테스트를 수행했다. 금융기관과 중앙은행 28곳이 참여했으며, 총거래 규모는 약 80만 스위스 프랑 상당이었다. 한국은행도 해당 테스트 참여 중앙은행에 포함된다. BIS Project Agorá

이는 실제 가치를 사용한 시험이라는 점에서 의미가 있다. 다만 제한된 참여자와 거래 시나리오에서 수행한 테스트이며, 일반 고객에게 개방된 전 세계 상용 서비스로 해석해서는 안 된다.

또한 24시간 처리를 지향하는 설계와 실제 테스트가 24시간 연속 운영을 입증했는지는 별개의 문제다.

SWIFT 공유원장: 기존 시스템과 연결하는 접근

SWIFT는 2026년 7월 9일, 블록체인 기반 공유원장이 초기 사용을 위한 준비를 마쳤다고 발표했다.

이 구조에서는 은행들이 자체 원장에 발행한 토큰화 예금을 조정하고, 최종 결제는 기존 시스템을 통해 완료하는 방식을 설명한다. SWIFT 공유원장 발표

이후 Standard Chartered와 HSBC도 해당 원장을 활용한 실거래를 발표했다. 설명에 따르면 두 은행 사이 의무를 기록·매칭·상계하고 기존 시스템에서 최종 결제를 수행했다. Standard Chartered 공식 발표

여기서는 공유원장에서 처리했다는 사실과 중앙은행 돈으로 최종 결제가 끝났다는 사실을 구분해야 한다.

Nexus: 기존 즉시지급 시스템을 연결하는 방향

모든 개선이 토큰화 원장을 필요로 하는 것은 아니다.

Project Nexus는 각국의 국내 즉시지급 시스템을 연결해 국경 간 지급을 지원하는 접근이다. BIS Project Nexus

현재 금융 인프라를 개선하는 길에는 메시지 표준화, 기존 시스템 연계, 공유원장 실험이 함께 존재한다.

12. SWIFT와 Finternet을 같은 종류로 비교하면 어려운 이유

지금까지의 내용을 나란히 두면 차이가 보인다.

항목 성격 중심 역할
SWIFT 기존 메시징 운영 중인 네트워크 금융 지시와 정보 교환
ISO 20022 표준 체계 금융 데이터의 의미와 구조 정렬
Finternet 미래 금융 시스템 비전 금융 생태계의 상호 연결
통합원장 인프라 설계 접근 자금·자산·처리 규칙의 연계
Project Agorá 실험 프로젝트 토큰화 기반 다중통화 도매 지급 검증
SWIFT 공유원장 초기 활용·실거래 검증이 진행되는 기능 은행의 토큰화 예금 처리 조정
Nexus 지급 시스템 연결 접근 국내 즉시지급 시스템 간 연계

따라서 “Finternet이 SWIFT를 대체하는가?”라는 질문만으로는 변화의 방향을 충분히 설명하기 어렵다.

SWIFT 같은 기존 참여자가 새로운 원장 기능을 추가할 수도 있고, 새로운 플랫폼이 기존 메시지 표준과 결제 시스템을 사용할 수도 있다.

앞으로 무엇이 바뀌는지는 어떤 업무가 어느 계층으로 이동하는지를 살펴봐야 알 수 있다.

13. 앞선 신원과 AML 주제는 어디에 연결될까?

금융 인프라가 빨라져도 거래 당사자와 권한, 위험을 확인하는 문제는 남는다.

디지털 신원 거래를 요청한 주체가 누구인가?
LEI 정확히 어느 법적 실체가 참여하는가?
vLEI 조직을 대신하는 사람의 역할은 무엇인가?
AML·고객확인 어떤 거래 관계이며 위험에 맞는 확인을 했는가?

이 표는 역할을 연결한 설명이다. 모든 프로젝트가 해당 기술을 필수로 사용한다는 뜻은 아니다.

새로운 플랫폼에서는 이런 확인을 거래 준비 단계와 연결하는 설계를 시도할 수 있다. Project Agorá도 규제 준수, 결제완결성, 개인정보 보호 같은 법적·운영적 문제를 함께 검토한다. BIS Project Agorá

확인 절차를 자동화하더라도 판단 근거와 책임이 없어지는 것은 아니다. 오히려 거래가 빨라질수록 실행 전 확인과 예외 처리의 중요성이 커진다.

14. 개발자는 어떤 질문으로 인프라를 평가해야 할까?

새로운 금융 기술을 볼 때 처리 속도와 원장 종류 외에도 확인할 항목이 있다.

다음은 시스템을 검토하기 위한 질문이다.

상태 접수·승인·자금 이용 가능·최종 결제를 구분하는가?
자산 무엇에 대한 청구권이 이동하는가?
실패 처리 일부 시스템 장애 시 어떤 상태로 남는가?
중복 방지 재시도 때문에 지급이 두 번 실행되지 않는가?
유동성 필요한 통화와 자금은 언제 확보하는가?
법적 기반 어느 규칙에 따라 이전이 최종 확정되는가?
보안·권한 누가 어떤 거래를 실행하고 승인할 수 있는가?
운영 기존 장부와 대사하고 장애 후 복구할 수 있는가?

특히 하나의 SUCCESS 상태로 모든 결과를 표현하면 문제가 생기기 쉽다.

메시지 전송에 성공했지만 결제는 대기 중일 수 있다. 고객이 자금을 사용할 수 있어도 은행 간 최종 결제는 나중에 이루어지는 구조일 수 있다.

시스템의 상태 모델은 실제 금융상의 책임과 확정 시점을 반영해야 한다.

국제 금융 인프라의 변화는 정보를 보내는 속도와 함께 서로 다른 기관의 장부·자산·규칙을 얼마나 일관되게 연결하는지에서 평가할 수 있다. Finternet과 관련 실험을 읽을 때도 이 기준을 적용하면, 기술적 가능성과 실제 운영 성과를 구분하기 쉬워진다.


참고 자료

PHP 취약점 두 개가 웹 인프라 전체의 문제가 된 이유

PHP 애플리케이션을 최신으로 유지해도 그 코드를 실행하는 PHP 런타임이 취약하면 위험은 남는다.


2026년 10월 20~21일, PHP 보안 업데이트를 앞두고 여러 국가의 보안기관과 서비스 운영사들이 긴급 대응에 나섰다.

이번 이슈는 PHP2Shell이라고 불리는 두 취약점이다.

  • CVE-2026-109618: 메모리 부족 처리 과정에서 발생하는 메모리 손상
  • CVE-2026-109619: 요청이 끝난 뒤 남은 내부 상태를 다음 요청에서 사용하는 문제

조건이 충족되면 인증되지 않은 공격자가 원격으로 코드를 실행할 수 있다. 두 취약점 모두 PHP 프로젝트 기준 CVSS v4.0 9.2, Critical로 평가됐다. PHP 공식 권고, NHS England 보안 공지

1. 언제 무슨 일이 있었을까?

먼저 사전 경고와 실제 패치 공개를 나눠 볼 필요가 있다.

10월 20일 PHP 프로젝트가 긴급 보안 릴리스를 사전 예고
10월 21일 취약점 상세와 수정 버전 공개
10월 21일 이후 보안기관, 호스팅사, 제품 공급사가 영향 확인과 업데이트 안내

ENISA 공동 성명에 따르면 PHP 보안 업데이트는 10월 21일 13:40 UTC, 한국 시간으로 10월 21일 오후 10시 40분에 공개됐다. ENISA 공동 성명

공개 전에는 운영 환경을 파악하고 업데이트를 준비하라는 경고가 중심이었다. 공개 이후에는 실제 수정 버전을 적용하는 단계로 넘어갔다.

따라서 ‘패치가 곧 나온다’는 초기 공지만 읽고 대응을 기다려서는 안 된다. 현재는 수정 버전과 배포판별 보안 패키지를 확인할 수 있다.

2. 왜 PHP 사이트 운영자들이 긴장했을까?

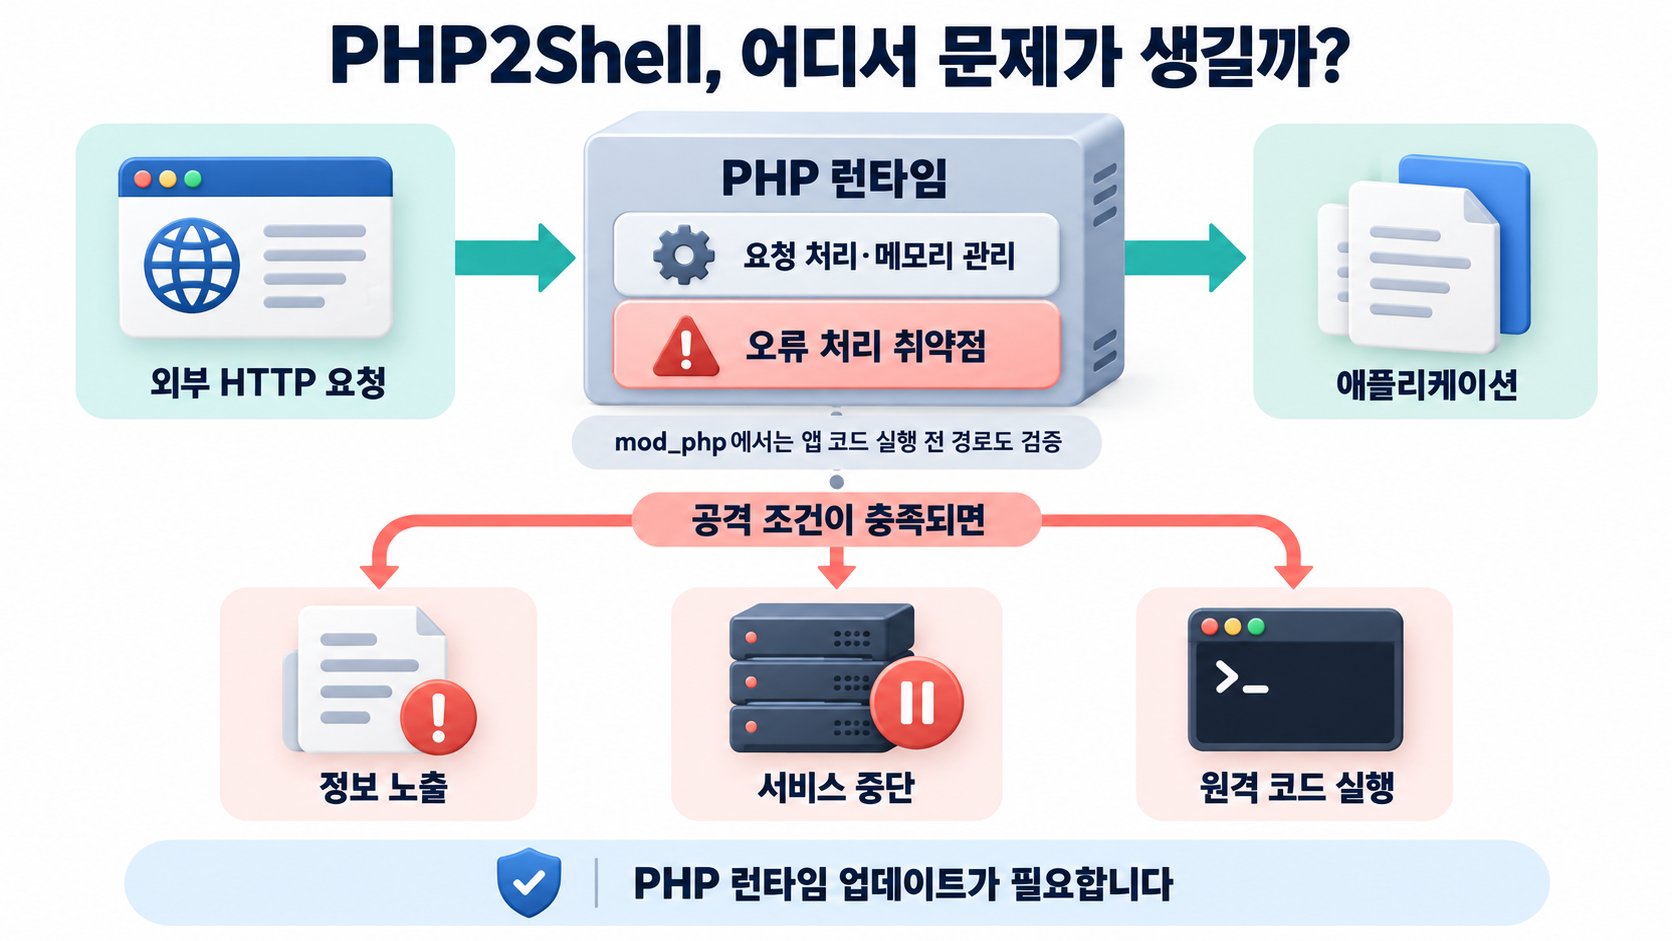
이번 문제는 특정 플러그인의 기능 하나에 한정된 취약점이 아니다. PHP 런타임의 요청 처리와 메모리 관리에 관련된 문제다.

구조를 단순화하면 다음과 같다.

외부 HTTP 요청
       ↓
웹 서버와 PHP 실행 환경
       ↓
PHP 내부의 요청 초기화·처리·정리
       ↓
애플리케이션 코드

특히 Apache의 mod_php에서 검증된 경로는 애플리케이션 코드가 시작되기 전에 공격이 발생할 수 있다.

로그인 검사나 프레임워크의 입력 검증이 실행되기 전 단계가 문제가 될 수 있다는 뜻이다.


PHP 공식 권고는 웹 요청을 처리하는 PHP 환경 전반을 점검 대상으로 안내하며 mod_php의 위험을 특히 높게 평가한다. PHP 공식 영향 범위

다만 모든 PHP 서비스에서 같은 요청 하나로 즉시 공격이 성공한다는 의미는 아니다. 실행 방식, 설정, 빌드, 확장 모듈, 애플리케이션 동작에 따라 구체적인 공격 조건이 달라진다.

3. CVE-2026-109618: 메모리가 부족해졌을 때

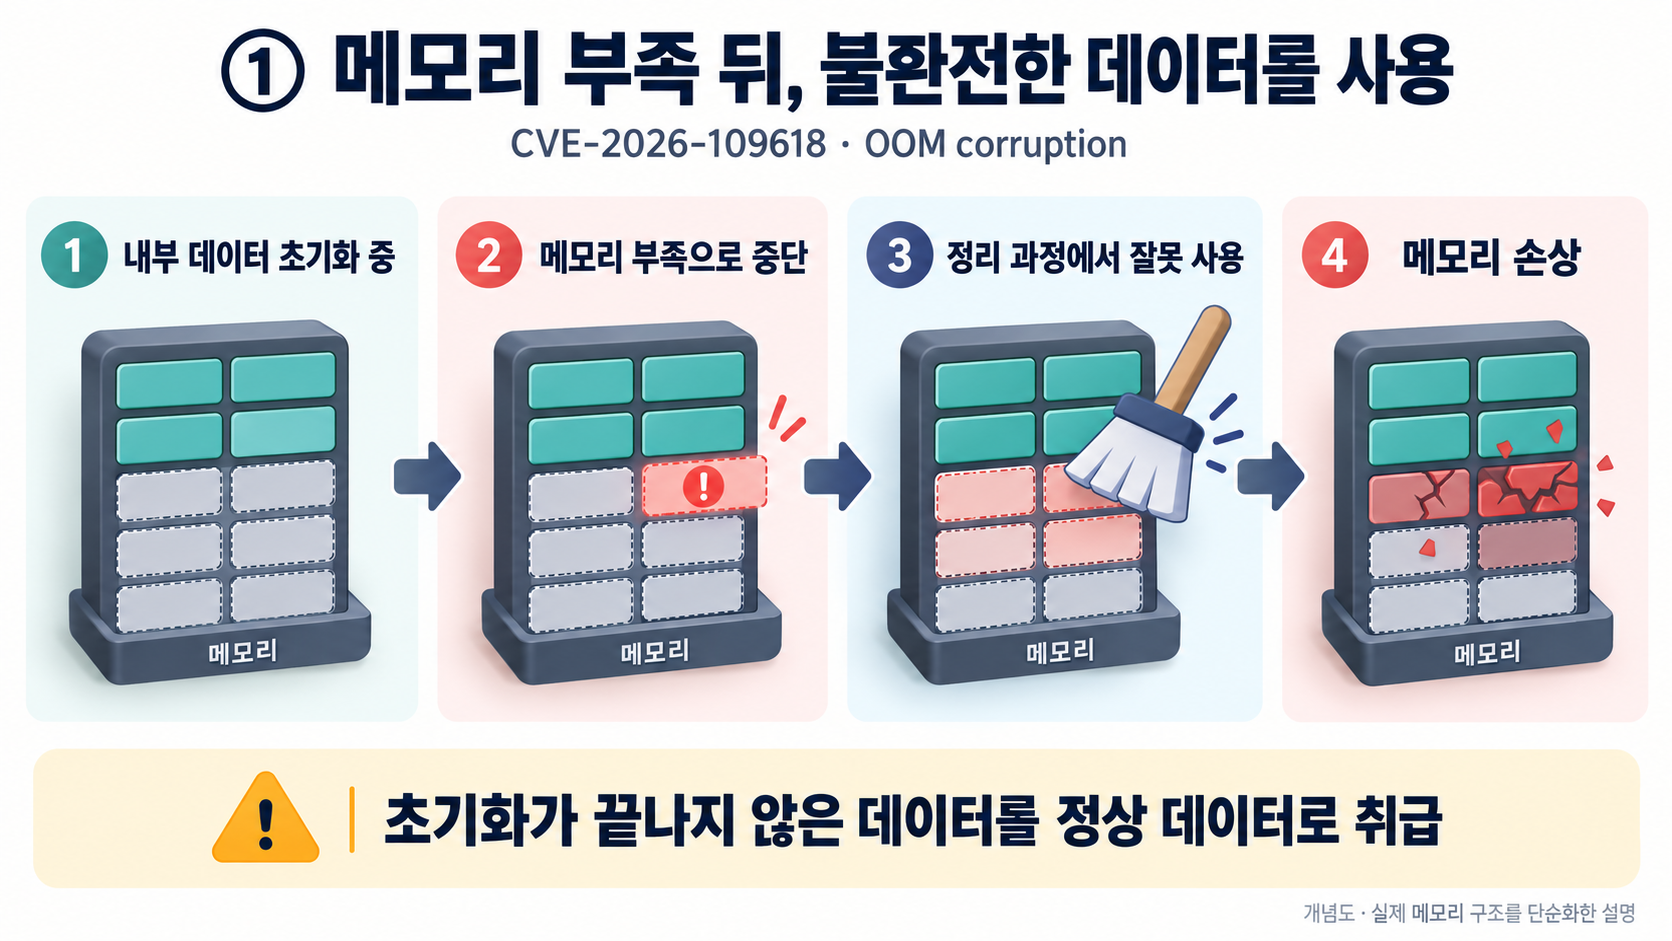
첫 번째 취약점의 공식 이름은 RCE via OOM corruption이다.


OOM은 Out of Memory, 메모리 부족을 뜻한다.

PHP는 요청을 처리하면서 필요한 메모리를 할당한다. 그런데 일부 내부 데이터는 완전히 초기화되기 전에도 다른 코드가 접근할 수 있는 상태가 된다.

이 시점에 메모리 부족으로 처리가 중단되면 다음 문제가 생길 수 있다.

내부 데이터 생성 시작
          ↓
초기화가 끝나기 전에 메모리 부족 발생
          ↓
현재 작업이 비정상적으로 중단
          ↓
요청 정리 코드가 불완전한 데이터를 정상 데이터처럼 사용
          ↓
메모리 손상

공식 권고는 PHP의 OOM 처리에 사용되던 longjmp()가 일부 문맥에서 안전하지 않은 조기 이탈을 일으키는 문제를 설명한다.

검증된 영향에는 웹 워커 계정 권한으로 실행되는 비인증 원격 코드 실행이 포함된다. mod_php에서는 기본 입력과 메모리 제한을 사용하는 환경에서도 HTTP를 통한 공격이 검증됐다. CVE-2026-109618 공식 기술 권고

메모리 부족이 왜 코드 실행으로 이어질까?

보통 메모리가 부족하면 요청이 실패하거나 프로세스가 종료될 것으로 예상한다.

하지만 불완전한 데이터를 정상적인 내부 구조로 해석하면 프로그램이 잘못된 메모리를 읽거나 그 값에 따라 동작할 수 있다. 즉, 공격자가 영향을 주는 입력과 메모리 배치가 결합하면 단순 장애를 넘어설 가능성이 생긴다.

이 취약점의 핵심은 요청 크기 자체보다 실패한 뒤에도 내부 상태를 안전하게 처리하는가에 있다.

4. CVE-2026-109619: 끝난 요청의 메모리를 다음 요청이 사용

두 번째 취약점은 RCE via stale global state다.

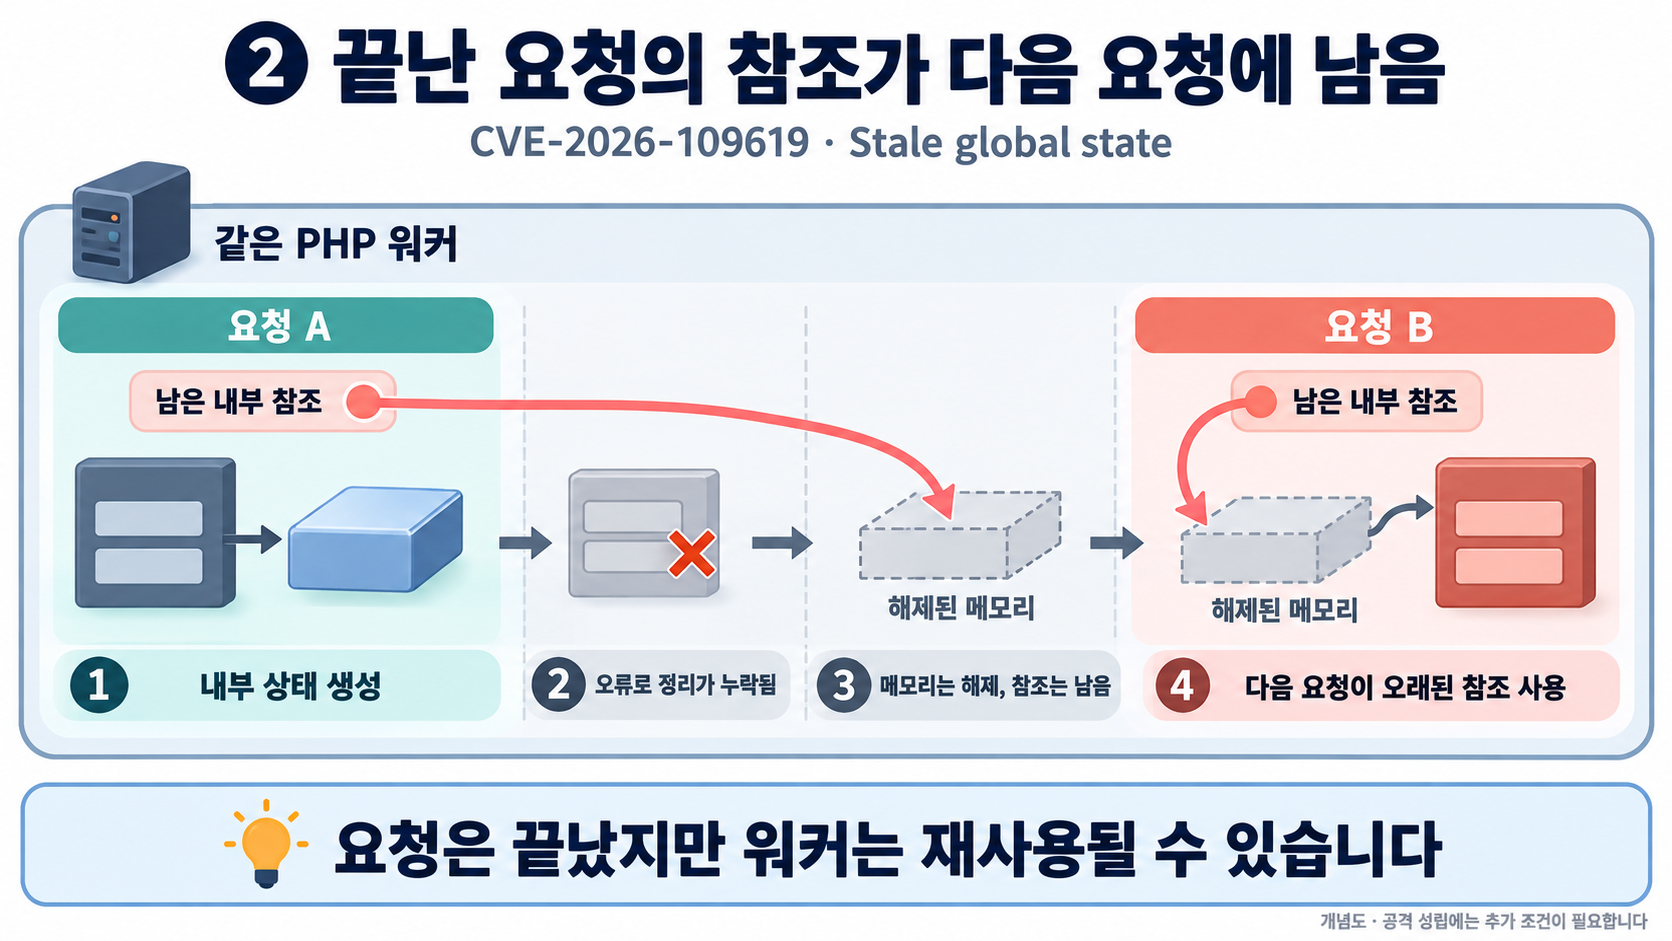
PHP 웹 워커는 하나의 요청을 처리한 뒤 다른 요청을 처리하도록 재사용될 수 있다. 각 요청의 메모리는 정리되더라도 워커 프로세스는 계속 살아 있는 구조다.

문제는 요청에 속한 데이터를 가리키는 내부 상태가 적절하게 초기화되지 않고 남는 경우다.

요청 A가 내부 상태 생성
          ↓
오류 등으로 정상적인 초기화, 정리 흐름 중단
          ↓
요청 A의 메모리는 해제
          ↓
워커에는 그 메모리를 가리키는 상태가 남음
          ↓
같은 워커가 요청 B를 처리
          ↓
이미 해제된 메모리를 사용

이런 문제를 Use-After-Free, 해제 후 사용이라고 부른다.

공식 권고에서는 메모리 노출과 원격 코드 실행을 확인했다. 공격을 일으키는 요청과 남은 상태를 사용하는 요청이 같은 워커에 도달해야 하는 등 조건이 존재한다. CVE-2026-109619 공식 기술 권고

이 문제는 두 사용자가 같은 애플리케이션 세션을 공유한다는 설명과 다르다. PHP 내부의 상태와 메모리 수명 관리가 요청 경계를 넘어 잘못 이어지는 문제다.

5. Apache와 PHP-FPM

공식 기술 권고는 실행 환경별 차이를 설명한다.

Apache mod_php 애플리케이션 실행 전 경로를 포함해 공격이 검증됨
PHP-FPM 초기화 실패 시 워커 종료 등 차이가 있지만 안전하다고 볼 수 없음
FrankenPHP·LiteSpeed 등 실행 방식별 조건이 다르며 공식 권고상 점검 대상

첫 번째 취약점에서 FPM은 요청 시작 실패 시 자식 프로세스를 종료하기 때문에 mod_php와 똑같은 경로가 유지되지 않는다. 다만 애플리케이션 실행 단계의 메모리 부족 경로 등은 별도로 고려해야 한다. OOM 취약점의 환경별 설명

두 번째 취약점에서는 FPM에서도 세션 생명주기와 관련된 RCE가 검증됐다. 해당 경로는 적절한 애플리케이션 동작에 의존한다. 상태 재사용 취약점의 검증 범위

따라서 ‘Nginx와 FPM을 쓰니까 괜찮다’고 판단하면 안 된다. 반대로 모든 실행 환경에서 공격 재현 조건이 동일하다고 설명하는 것도 부정확하다.

6. 공격이 실제로 발생하고 있을까?

여기서는 세 가지를 나눠야 한다.

취약점 재현 연구자가 통제된 환경에서 공격 성공
공격 시도 관측 실제 네트워크에서 관련 공격 트래픽 확인
침해 확인 특정 시스템에서 공격 성공과 피해 확인

Cloudflare는 공개 전후에 관련 공격 트래픽을 관측했고, 공격자가 방어를 우회하려고 입력을 변경하는 움직임도 확인했다고 밝혔다. Cloudflare 대응 보고

이것은 현실의 공격 시도가 있다는 근거다. 그러나 그 사실만으로 모든 시도가 성공했거나 특정 규모의 사이트가 침해됐다고 단정할 수는 없다.

취약점이 존재하는 것과 내 서버가 이미 침해됐는지는 별도의 조사 문제다.

7. 어떤 버전으로 업데이트해야 할까?

이번 두 취약점을 수정한 PHP 프로젝트의 버전은 다음과 같다.

PHP 8.2 8.2.35
PHP 8.3 8.3.36
PHP 8.4 8.4.27
PHP 8.5 8.5.12

해당 계열에서는 이 수정 버전 또는 이후의 적절한 보안 릴리스를 적용해야 한다. NHS England 수정 버전 안내

배포판 버전은 숫자만 비교하면 안 된다

Ubuntu와 Red Hat 같은 공급사는 기존 버전에 보안 수정만 가져오는 백포트를 제공할 수 있다.

예를 들어 Ubuntu는 이번 문제에 대해 Ubuntu 24.04 LTS용 8.3.6-0ubuntu0.24.04.13 패키지를 수정 패키지로 안내한다. 앞부분이 8.3.6이라고 해서 곧바로 미패치라고 판단하면 안 되는 이유다. Ubuntu USN-8948-1

판단 기준은 다음 두 가지다.

직접 설치한 PHP
→ PHP 프로젝트의 수정 버전 확인

배포판·제품 공급사가 관리하는 PHP
→ 해당 공급사의 보안 공지와 패키지 전체 버전 확인

PHP 8.1 이하를 사용한다면?

PHP 프로젝트의 정규 지원은 끝났지만, 일부 배포판과 LTS 공급사는 백포트 수정을 제공한다.

이번에는 심각성을 고려해 PHP 7.4, 8.0, 8.1의 최소 소스 백포트도 별도로 제공됐다. 이는 해당 계열의 정규 지원이 재개됐다는 뜻은 아니다. 공급사 패치 여부를 확인하고 지원 버전으로 이전할 계획이 필요하다. PHP 공식 업데이트 안내

8. 우리 서비스에서 PHP를 어디에 쓰는지부터 찾아야 한다

직접 작성한 PHP 사이트만 확인하면 빠뜨리는 자산이 생길 수 있다.

점검 대상에는 다음이 포함될 수 있다.

  • 웹서비스와 CMS
  • 관리 콘솔과 내부 도구
  • 컨테이너 이미지
  • 상용·오픈소스 제품에 포함된 PHP
  • 호스팅 사업자가 관리하는 실행 환경
  • 오래된 테스트·스테이징 서비스

ENISA도 PHP를 직접 사용하는 것처럼 보이지 않는 제품에 PHP가 포함될 수 있다고 지적하며 공급사와 영향 여부를 확인하도록 권고한다. ENISA 영향 확인 지침

php -v만 확인하면 충분할까?

다음 명령은 기본적인 확인에 도움이 된다.

php -v
php --ini

각각 명령줄 PHP의 버전과 설정 파일 정보를 보여준다. PHP 명령줄 공식 문서

하지만 명령줄에서 실행되는 PHP와 실제 웹 요청을 처리하는 PHP가 다를 수 있다.

여러 버전이 설치됐거나 컨테이너, FPM 풀, 웹 서버 모듈이 분리된 환경에서는 특히 주의해야 한다. 확인할 대상은 현재 사용자 요청을 처리하는 프로세스와 이미지다.

phpinfo()로 설정을 확인할 수도 있지만 환경정보와 경로 등이 출력되므로 점검 정보를 공개 페이지로 노출하지 않도록 해야 한다. PHP phpinfo() 문서

9. 패키지 설치가 끝나면 대응도 끝날까?

업데이트 파일이 설치됐다는 사실과 실행 중인 워커가 수정된 코드를 사용한다는 사실은 다르다.

다음은 대응을 정리하기 위한 운영 흐름이다.

PHP 사용 자산 파악
         ↓
공급사 수정 패키지·이미지 확인
         ↓
업데이트 및 필요한 재배포
         ↓
기존 워커 교체·재시작 확인
         ↓
실제 서비스 환경 재확인
         ↓
기능·오류율·보안 로그 확인

컨테이너 환경에서는 새 이미지를 만들었더라도 기존 파드가 계속 서비스할 수 있다. 로드밸런서 뒤에 서버가 여러 대 있다면 일부 인스턴스만 업데이트됐을 수도 있다.


운영 기록에는 적어도 다음 내용을 남기면 좋다.

실행 버전 웹 요청을 처리하는 PHP의 실제 버전
수정 근거 공급사 공지·패키지·이미지 정보
적용 범위 서버·풀·컨테이너 전체 반영 여부
프로세스 이전 워커가 남아 있는지
기능 확인 로그인·업로드·배치 등 주요 기능
복구 계획 문제가 생겼을 때 사용할 안전한 대안

롤백이 필요하더라도 취약한 이전 버전을 외부에 그대로 재노출하는 결과가 되지 않도록 계획해야 한다.

10. 바로 업데이트하기 어렵다면 어떻게 해야 할까?

PHP 공식 권고는 업데이트만이 완전한 해결책이라고 명시한다.

일부 설정 변경은 특정 경로의 위험을 줄일 수 있지만 전체 취약점을 제거하지 못한다. 예를 들어 세션 업로드 진행률 기능 비활성화는 확인된 일부 경로에 대한 조치이며 다른 내부 상태 문제까지 해결하지 않는다. PHP 공식 완화 지침

ENISA와 영국 NCSC는 즉시 수정이 어려운 경우 노출된 시스템의 격리나 일시적인 오프라인 전환을 검토하도록 안내한다. ENISA 권고, NCSC 권고


또한 이번 문제에서는 일반적인 설정 직관을 그대로 적용하기 어렵다.

  • 메모리 제한을 더 낮추면 안전하다고 단정할 수 없다.
  • 오류 메시지를 숨기는 것은 내부 상태 오류를 해결하지 않는다.
  • 애플리케이션 코드에서 설정을 바꾸기 전에 취약한 처리가 시작될 수 있다.

특히 OOM 관련 임시 설정은 가용성과 자원 제한에도 영향을 준다. 공식 권고의 전제와 한계를 함께 읽어야 한다.

WAF가 있으면 업데이트를 미뤄도 될까?

Cloudflare는 WAF 보호를 배포했다고 발표하면서도 PHP 패치를 적용하라고 권고한다.

WAF는 추가 방어 계층이다. 공격 변형과 서비스 경로를 고려해야 하며, 요청이 WAF를 우회해 원본 서버에 직접 도달하는 구조라면 보호 범위도 달라진다. Cloudflare의 보호 범위와 패치 권고

11. 어떤 로그를 살펴봐야 할까?

공식 기술 권고는 오류와 설정 점검을 함께 수행하도록 설명한다.

살펴볼 자료의 예시는 다음과 같다.

  • PHP·웹 서버·리버스 프록시 오류 로그
  • 메모리 부족과 워커 비정상 종료
  • 반복되는 치명적 오류와 실행시간 초과
  • 초기화나 종료 과정의 경고
  • 특정 경로·입력 유형에 집중되는 실패

다만 이런 증상은 정상적인 장애에서도 발생할 수 있다. 오류가 있다는 사실만으로 침해를 확정할 수 없고, 오류가 없다고 안전을 보장할 수도 없다. 기록되기 전에 실패하거나 관련 로그 수준이 비활성화돼 있을 수 있다. 공식 로깅·설정 감사 지침

침해 징후가 있다면 취약점 수정과 사고 대응을 나눠 진행해야 한다.


업데이트는 앞으로 같은 취약점이 악용되는 경로를 막지만, 이미 변경된 파일이나 탈취된 비밀정보를 원래 상태로 돌리지는 않는다. 이 경우 로그와 증거를 보존하고 관련 계정과 키, 서버 상태를 조사하는 절차가 필요하다.

12. AI가 발견했다는 점은 어떻게 봐야 할까?

이번 사건이 크게 주목받은 이유 중 하나는 AI를 활용한 취약점 발견이다.

OpenAI의 공개 설명에 따르면 Calif가 AI를 활용해 취약점을 발견했고, Wiz도 두 취약점을 독립적으로 발견하고 보고했다. PHP 유지보수자들이 수정과 릴리스를 주도했으며 여러 연구팀과 보안 조직이 대응에 참여했다. OpenAI의 공동 대응 설명


이 사례에서 확인되는 것은 AI 기반 탐색과 사람이 함께 검증했다는 사실이다.

이것만으로 AI가 모든 취약점을 찾을 수 있다거나 사람이 보안 검토를 할 필요가 없어졌다고 결론 내릴 수는 없다.

운영 관점에서는 다른 질문이 중요해진다.

취약점 발견이 빨라졌을 때 우리 조직은 노출된 자산을 찾고 수정하는 속도도 따라갈 수 있을까?

13. 이번 사건에서 남는 운영 과제

PHP2Shell은 애플리케이션 코드 바깥의 런타임도 보안 관리 대상이라는 사실을 보여준다.

대응력을 점검하려면 다음 질문에 답할 수 있어야 한다.

PHP가 어디에 있는가? 자산과 실행 환경 관리
어떤 수정이 필요한가? 공급사 권고·백포트 해석
전부 적용됐는가? 프로세스·컨테이너·서버 검증
즉시 적용이 어려우면? 노출 축소와 서비스 운영 결정
이미 악용됐다면? 로그·탐지·사고 대응
다시 발생하면? 반복 가능한 긴급 패치 절차

이번 사건의 우선순위는 실제로 웹 요청을 처리하는 PHP를 찾아 수정된 실행 환경으로 교체하는 것이다. 이후에는 패치가 모든 인스턴스에 반영됐는지 기존 노출 기간에 이상 징후가 있었는지까지 확인해야 한다.


참고 자료

AML, KYC, CDD와 금융 범죄 방지의 구조

상대방이 누구인지 확인했다면, 그 사람이 하는 거래도 안전하다고 볼 수 있을까?


은행 앱에서 계좌를 개설하다 보면 여러 질문을 받는다.

직업은 무엇인지, 계좌를 어떤 목적으로 사용하는지, 거래자금은 어디에서 마련했는지 확인한다. 법인 계좌를 만들 때는 회사 정보뿐 아니라 실제 소유자와 거래 담당자의 권한을 묻기도 한다.


이미 신분증을 제출했는데 왜 이런 정보까지 필요한 걸까?

신원이 확인됐다는 사실과 금융거래의 위험이 충분히 파악됐다는 사실은 다르기 때문이다.


앞선 글에서는 개인의 디지털 신원과 기업의 LEI와 vLEI를 살펴봤다. 이번에는 확인한 신원정보가 금융 범죄 방지 과정에서 어떻게 활용되는지 알아본다.

국제 기준은 FATF 권고를, 한국 제도는 금융정보분석원과 관련 법령을 기준으로 설명한다. 금액 기준과 국내 제도 설명은 2026년 10월 22일 확인한 공식 자료를 바탕으로 한다.

1. AML은 금융 범죄 방지 체계의 한 부분이다

AML은 Anti-Money Laundering, 자금세탁방지를 뜻한다.

자금세탁은 일반적으로 불법적인 자금의 출처를 숨겨 합법적인 것처럼 보이게 만드는 과정이다. AML은 이를 예방하고 발견하기 위한 법률, 제도, 내부 통제와 업무 절차를 포함한다.

금융정보분석원도 자금세탁방지제도를 사법제도, 금융제도, 국제협력이 연결되는 종합적인 관리체계로 설명한다. 금융정보분석원: 자금세탁방지제도

함께 등장하는 용어도 구분해 두면 좋다.

용어 의미 관심사
AML 자금세탁방지 불법자금의 은닉 및 위장 방지
CFT 테러자금조달방지 테러 활동 등에 사용되는 자금의 조달 방지
제재 준수 적용되는 제재와 거래 제한 준수 거래 대상과 행위에 대한 제한 확인
사기 방지 금융사기 예방 및 탐지 계정 탈취, 결제사기 등 피해 방지

이 업무들은 데이터를 공유하고 함께 운영될 수 있지만, 목적과 법적 판단 기준이 모두 같지는 않다.

FATF는 자금세탁, 테러자금조달, 대량살상무기 확산금융에 대응하는 국제 기준을 제시한다. 각국은 이를 자국의 법률과 제도에 맞게 이행한다. 따라서 FATF 문서의 설명과 특정 국가에서 직접 적용되는 의무를 구분해야 한다. FATF Recommendations

2. KYC, CDD, EDD는 어떻게 다를까?

처음 접하면 가장 헷갈리는 용어들이다.

용어 풀어쓴 의미 의미
KYC Know Your Customer 고객을 알고 이해하는 정책, 업무
CDD Customer Due Diligence 고객과 실제 소유자 등을 확인하고 주의를 기울이는 절차
EDD Enhanced Due Diligence 높은 위험에 대응하는 강화된 고객확인
SDD Simplified Due Diligence 허용된 저위험 상황에 적용하는 간소화된 조치
KYB Know Your Business 기업 고객의 신원과 구조 등을 확인하는 업무를 부르는 표현

KYC와 CDD의 경계는 자료나 조직마다 겹친다. 금융정보분석원도 고객확인제도를 고객알기정책이라고 설명한다. 두 용어가 언제나 엄격하게 분리된 별도 단계라고 이해할 필요는 없다. 금융정보분석원: 고객확인제도

실무에서는 KYC를 전체 정책이나 고객확인 업무의 이름으로, CDD를 구체적인 확인 의무와 절차를 설명하는 말로 사용하는 경우가 많다.

또한 KYB를 사용한다고 해서 법적 의무가 새로운 이름으로 대체되는 것은 아니다. 기업 고객에 대한 CDD를 설명하는 실무 용어로 읽는 편이 안전하다.

3. 고객확인은 무엇을 확인하는 과정일까?

신분증 확인은 중요한 출발점이다. 하지만 고객확인에는 그보다 넓은 내용이 포함된다.

FATF 권고 10의 핵심을 정리하면 다음과 같다.

  1. 고객을 식별하고 신원을 검증한다.
  2. 실제 소유자를 파악하고 신원을 검증하기 위한 합리적 조치를 취한다.
  3. 거래 관계의 목적과 성격을 이해한다.
  4. 거래 관계 동안 지속적으로 주의를 기울이고 거래를 살핀다.

즉, 고객에 대한 이해와 실제 거래를 연결하는 과정이다. FATF 권고 10

한국의 고객확인제도도 신원 확인과 검증, 실제 소유자 확인, 필요한 거래 목적과 자금 원천 확인 등을 다룬다. 실명확인만으로 고객확인이 모두 끝나는 구조는 아니다. 금융정보분석원: 고객확인 내용

가상의 기업 고객을 예로 들면 다음 질문들이 이어진다.

어느 회사인가?
      ↓
누가 회사를 지배하거나 통제하는가?
      ↓
신청자는 회사를 대신할 권한이 있는가?
      ↓
어떤 사업과 거래를 위해 서비스를 사용하는가?
      ↓
실제 거래가 이 설명과 부합하는가?

확인 항목과 증빙의 범위는 고객 유형, 상품, 위험, 적용 법령에 따라 달라진다.

4. 실제 소유자는 대표자와 다를 수 있다

실무에서 말하는 ‘실소유자’는 국내 제도에서 실제 소유자라고 표현한다. 영어로는 Beneficial Owner다.

중심 질문은 다음과 같다.

고객을 최종적으로 소유하거나 지배·통제하는 자연인은 누구인가?


법인 등기상 대표자나 계좌를 개설하러 온 담당자가 반드시 실제 소유자인 것은 아니다.

예를 들어 다음과 같은 구조를 생각할 수 있다.

자연인 A
   ↓
해외 지주회사 B
   ↓
국내 사업회사 C

고객이 C라고 해서 B의 회사 이름을 확인하는 것으로 모든 질문이 해결되지는 않는다. 적용 기준에 따라 상위 소유 및 통제 구조와 자연인을 파악해야 한다.

FATF는 정확하고 최신인 실제 소유자 정보에 접근할 수 있도록 여러 정보원을 결합하는 접근을 강조한다. FATF: 법인의 실제 소유자 지침

지분율만 계산하면 끝날까?

지분은 중요한 판단 근거지만 통제는 다른 방식으로도 발생할 수 있다. FATF 용어집도 소유를 통한 통제 외에 다른 수단을 통한 통제를 다룬다. FATF Glossary

한국 금융정보분석원의 일반 안내는 법인·단체의 경우 25% 이상 지분 소유자 확인을 출발점으로 하고, 확인이 어려운 경우 다른 지배 기준과 대표자 확인으로 이어지는 단계적 절차를 설명한다. 구체적인 적용과 예외는 관련 법령에 따라 확인해야 한다. 금융정보분석원: 실제 소유자 확인

어떤 국가의 지분 기준 하나를 전 세계 공통의 완전한 정의로 사용해서는 안 된다.

5. 위험기반접근법: 모두에게 같은 강도의 확인이 필요할까?

RBA·Risk-Based Approach, 위험기반접근법은 위험에 비례해 조치를 설계하는 접근이다.

고객, 상품, 거래 방식, 지역 등 관련 요소를 평가하고 필요한 확인과 모니터링의 강도를 정한다.

예를 들어 일상적인 국내 거래를 위한 개인 계좌와 복잡한 소유 구조를 가진 기업의 국제 거래는 살펴봐야 할 위험이 다를 수 있다. 이것만으로 어느 한쪽이 불법이라는 뜻은 아니다.

위험이 높으면 추가 정보와 검증, 더 강한 모니터링 등이 필요할 수 있다. 낮은 위험에서는 법과 제도가 허용하는 간소화 조치를 적용할 수 있다. FATF도 비례성과 저위험 영역의 간소화 조치를 강조한다. FATF 위험기반접근법 관련 개정 안내

EDD는 서류를 많이 받는 일일까?

추가 서류의 양보다 어떤 위험을 해소하려는지가 중요하다.

확인 목적에 따라 다음과 같은 조치를 고려할 수 있다.

  • 사업과 거래 목적에 대한 추가 설명
  • 자금이나 재산 형성 경위에 대한 확인
  • 소유 및 통제 구조의 추가 검증
  • 필요한 상위 책임자의 승인
  • 모니터링 강도와 검토 주기 조정

‘서류를 받았다’와 ‘위험에 관한 의문이 해소됐다’는 다른 상태다.

6. 자금의 원천과 재산의 원천도 다르다

EDD 문서에서는 Source of Funds와 Source of Wealth가 자주 등장한다.

Source of Funds 이번 거래에 사용하는 자금이 어디서 왔는가? 급여, 자산 매각대금, 사업대금
Source of Wealth 전체 재산을 어떤 과정을 통해 형성했는가? 장기간의 사업소득, 투자, 상속

이번 입금이 다른 은행 계좌에서 왔다는 설명만으로 경제적인 자금 원천이 충분히 밝혀졌다고 볼 수는 없다. 어느 계좌에서 이동했는지와 어떤 활동으로 만들어진 돈인지는 서로 다른 질문이다.

FATF의 PEP 지침도 자금의 원천과 재산의 원천을 구분해 다룬다. 확인 범위와 검증 강도는 적용 요건과 위험에 맞춰 정해야 한다. FATF PEP Guidance

7. 제재 대상 확인과 PEP 확인은 같은 일이 아니다

고객 이름을 명단과 비교한다고 해서 모든 스크리닝이 동일한 판단을 하는 것은 아니다.

제재 스크리닝

적용되는 제재나 거래 제한의 대상인지 확인하는 업무다.

한국에서도 특정 개인, 법인, 단체를 금융거래 등에서 제한대상자로 지정하고 관련 거래를 제한하는 제도를 운영한다. 구체적인 제한과 허가 요건은 적용 제도에 따라 판단해야 한다. 금융정보분석원: 금융거래등 제한대상자

PEP 확인

PEP는 Politically Exposed Person, 주요 공적 직무를 맡았거나 맡은 사람 등을 가리킨다.

직무와 영향력이 악용될 가능성에 대응하는 예방적 조치의 대상이지, 범죄자 명단이라는 뜻은 아니다. FATF도 PEP라는 이유만으로 범죄에 연루됐다고 해석해서는 안 된다고 명시한다. 외국, 국내, 국제기구 PEP 등에 대한 구체적 조치도 구분된다. FATF PEP 안내

이름이 같으면 바로 같은 사람일까?

동명이인, 번역과 음역, 약칭 때문에 일치 후보가 생길 수 있다.

서비스에서는 생년월일, 식별정보, 소재지 등 사용 가능한 근거를 대조해 동일인 여부를 검토하도록 설계할 수 있다.

중요한 구분은 다음과 같다.

이름 유사성 발견
        ≠
동일인 확인
        ≠
적용되는 법적 조치 결정

이름 매칭 점수 하나에 최종 판단까지 맡기면 정상 고객에게 불필요한 피해를 줄 수 있다.

8. 거래 모니터링은 고객확인과 어떻게 연결될까?

고객확인으로 거래 목적과 사업을 이해했다면 이후 거래가 그 설명과 부합하는지 살펴볼 수 있다.


예를 들어 고객이 설명한 사업 규모나 거래 상대방과 실제 활동 사이에 큰 차이가 발견됐다고 하자. 시스템은 검토할 신호를 만들 수 있지만 그 차이만으로 범죄가 확정되지는 않는다.

바젤위원회 지침은 최신 CDD 정보와 고객 프로필을 활용해 위험 변화를 파악하고, 비정상 거래 경보를 추가 평가하도록 설명한다. 바젤위원회 AML/CFT 지침

이를 서비스 흐름으로 표현하면 다음과 같다.

고객정보 + 거래정보
         ↓
탐지 규칙, 분석 모델
         ↓
검토 경보 생성
         ↓
관련 정보와 고객 맥락 조사
         ↓
추가 확인, 위험 재평가, 보고 여부 판단

이 흐름은 설명용 예시다. 실제 처리 순서와 조치는 기관 및 법적 요건에 따라 달라진다.

특히 경보, 내부 조사 사건, 외부 보고를 구분해야 한다. 경보가 생성됐다는 이유만으로 자동으로 외부 보고나 거래 제한이 결정되는 것은 아니다.

9. STR과 CTR: 의심을 보고하는가, 현금거래 사실을 보고하는가?

한국 제도에서 자주 혼동하는 두 가지가 있다.

명칭 의심거래보고(STR) 고액현금거래보고(CTR)
중심 기준 자금세탁 등으로 의심되는 합당한 근거 법령상 기준에 해당하는 현금거래
핵심 내용 의심하는 거래와 그 근거 거래자의 신원, 일시, 금액 등 객관적 사실
범죄 확정 여부 확정 판결을 보고하는 제도가 아님 보고 사실만으로 범죄를 의미하지 않음

STR: 의심거래보고

금융정보분석원은 불법재산이나 자금세탁행위 등으로 의심되는 합당한 근거가 있는 경우 보고하는 제도로 설명한다.

보고 이후에는 KoFIU가 관련 정보를 종합 및 분석하고 필요한 경우 법집행기관에 정보를 제공하는 과정이 이어진다. 보고 자체와 수사, 기소, 유죄 판단은 다른 단계다. 금융정보분석원: STR

CTR: 고액현금거래보고

공식 안내에 따르면 한국에서는 동일 금융회사에서 동일인 명의로 1거래일 동안 1천만원 이상 현금이 입금되거나 출금되는 경우가 기본적인 보고 기준이다. 실제 적용에는 법령상 합산 방식과 예외 등을 함께 확인해야 한다. 금융정보분석원: CTR

여기서 ‘현금거래’라는 범위가 중요하다. 금융위원회는 이체나 송금이 CTR의 현금거래 대상과는 다르다고 설명한다. 금융위원회 CTR 설명

CTR 기준에 해당하지 않는 거래라도 별도의 의심 근거가 있다면 STR 검토 대상이 될 수 있다. 두 제도를 같은 금액 필터로 구현하면 안 되는 이유다.

10. 고객확인은 가입 이후에도 계속된다

계좌를 개설할 때 확인한 정보가 계속 정확하리라는 보장은 없다.

기업의 실제 소유자가 바뀔 수 있고 사업 내용이나 거래 목적이 달라질 수도 있다. 또 개인 고객의 거래 양상이 변화할 수도 있다.

따라서 서비스 설계에서는 보통 두 가지 갱신 경로를 함께 고려할 수 있다.

주기적인 검토 위험과 정책에 따라 고객정보 재확인
사건에 따른 검토 소유 구조 변경, 새로운 위험 정보, 중요한 거래 변화

모든 고객에게 같은 주기를 적용해야 한다는 뜻은 아니다. 중요한 변화가 생기면 예정된 검토일 이전에도 대응할 수 있어야 한다.

한국에서는 정보 제공 거부 등으로 고객확인을 할 수 없는 경우 신규 거래 거절이나 기존 거래 종료, 의심거래보고 여부 검토에 관한 규정도 있다. 다만 일시적인 시스템 오류를 곧바로 고객의 정보 제공 거부와 동일하게 처리해서는 안 된다. 특정금융정보법 제5조의2

11. 디지털 신원과 LEI, vLEI는 어디에 도움이 될까?

앞선 두 편과 연결하면 역할이 명확해진다.

구성 요소 지원할 수 있는 부분 별도로 남는 판단
디지털 신원 개인의 신원 확인 및 검증 거래 목적과 위험
LEI 법적 실체의 식별과 참조정보 연결 자연인 실제 소유자 확인 등
vLEI 조직과 사람의 역할과 권한 검증 구체적인 거래 허용 여부
AML 업무 신원, 위험, 거래를 연결한 지속적 관리 법령과 기관 정책에 따른 조치

FATF의 디지털 신원 지침은 디지털 ID를 고객 식별하거나 검증에 사용할 때 기술, 운영체계, 보증 수준과 위험에 대한 적합성을 평가하도록 다룬다. 또한 지속적인 고객확인을 지원할 가능성도 설명한다. FATF Digital Identity Guidance

따라서 디지털 신원 증명에 성공했다는 이유만으로 고객확인 전체가 끝났다고 처리해서는 안 된다.

기업 식별정보와 역할 자격증명을 활용할 때도 실제 소유자 자료, 상태의 최신성, 거래 목적에 대한 판단을 연결해야 한다.

12. IT 시스템으로 구현하면 무엇이 중요할까?

다음은 AML 시스템을 이해하기 위한 개념적인 구성이다.

고객, 기업, 실제 소유자 정보
                ↓
       신원 검증 및 스크리닝
                ↓
          고객 위험평가
                ↓
     거래 모니터링과 정보 갱신
                ↓
        경보 검토, 사건 관리
                ↓
     필요한 조치, 보고, 증거 보관

운영에서는 이 흐름이 반복되며, 새 정보가 이전 판단을 바꿀 수도 있다.

판단 결과와 근거를 함께 남긴다

‘고위험’이라는 결과만 저장하면 나중에 설명하기 어렵다.

설계 시 다음 정보를 함께 관리하는 것을 고려할 수 있다.

  • 평가에 사용한 정보와 확인 시점
  • 규칙, 모델, 정책의 버전
  • 경보와 판단을 연결하는 근거
  • 검토자와 승인자
  • 예외 처리 및 재검토 이력

외부 솔루션의 결과 해석

이름 매칭, 신원 검증, 위험평가를 외부 사업자에게 맡길 수 있다. 그래도 결과가 무엇을 의미하고 어떤 한계가 있는지 이해해야 한다.

바젤위원회도 은행이 제3자를 활용하더라도 고객확인과 AML/CFT 준수 책임은 은행에 남는다고 설명한다. 바젤위원회 제3자 활용 지침

AI는 검토를 돕되 근거를 만들어내지 않게

활용 예시로는 자료 추출, 동명이인 검토 보조, 사건 시간순 정리, 조사 문서 초안 작성 등을 생각할 수 있다.

이때 AI가 추론한 내용과 확인된 사실을 구분하고, 원문 자료로 돌아갈 수 있어야 한다. FATF의 신기술 보고서도 효율성뿐 아니라 설명가능성, 데이터 품질과 운영상의 위험을 함께 다룬다. FATF: AML/CFT 신기술의 기회와 과제

경보 수만으로 성과를 판단하지 않는다

많은 경보가 항상 좋은 탐지를 뜻하지는 않는다. 정상 거래를 지나치게 많이 경보로 만들면 검토 역량이 소진될 수 있다.

다음은 운영 지표의 예시다.

영역 살펴볼 항목
정보 품질 누락, 오류, 갱신 지연
스크리닝 동일인 확인 정확도와 검토 시간
모니터링 유효 경보, 검토 적체, 발견하지 못한 위험
사건 관리 증거의 충실성, 처리 시간, 재현 가능성
고객 영향 오탐에 따른 지연과 불필요한 제한

이 지표들은 함께 봐야 한다. 보고 건수 증가만으로 범죄 탐지 성과가 높아졌다고 단정할 수도 없다.

신원정보와 거래의 맥락

개인의 신원을 확인하면 누구인지에 대한 정보를 얻는다. 기업 신원을 확인하면 어느 법적 실체이며 담당자가 어떤 역할을 하는지 이해할 수 있다.

금융 범죄 방지에서는 그다음 질문이 이어진다.

이 고객은 왜 서비스를 사용하는가? 실제 거래가 설명과 부합하는가? 새로운 정보가 기존 판단을 바꿔야 하는가?

고객확인 정보는 이런 질문을 판단하기 위한 기준점이 된다. 거래 모니터링에서 발견한 변화는 다시 고객정보와 위험평가를 갱신하는 근거가 된다.

AML 시스템을 설계한다면 신분증 검사 결과를 저장하는 기능과 함께 정보, 위험, 거래, 검토 결과가 서로 갱신되는 구조를 살펴봐야 한다.


참고 자료

거래 상대가 실제로 존재하는 회사라는 사실과, 눈앞의 사람이 그 회사를 대표할 수 있다는 사실은 서로 다른 증명이 필요하다.


새로운 협력사에서 계약서를 보내왔다고 가정해 보자.

회사 이름과 주소가 적혀 있고, 담당자는 회사 이메일을 사용한다. 계약서에는 ‘재무 담당 임원’이라는 직함과 서명도 들어 있다.

이 정보만으로 계약을 진행해도 될까?

먼저 확인할 것이 있다. 같은 이름의 다른 회사는 아닌지, 계약 상대가 본사인지 자회사인지, 서명한 사람이 실제로 그 회사에서 일하는지 살펴봐야 한다. 그 사람이 해당 계약을 체결할 권한을 갖고 있는지도 별개의 문제다.

앞선 디지털 신원 글이 개인의 신원과 자격을 다뤘다면, 이번에는 기업의 신원과 기업을 대신하는 사람의 역할을 살펴본다.

이때 중심이 되는 개념이 LEI와 vLEI다.

1. 기업 신원에서는 무엇을 확인해야 할까?

기업 간 거래에서 필요한 확인을 세 단계로 나누면 이해하기 쉽다.

확인 대상핵심 질문
기업 자체 우리가 거래하려는 법적 실체가 정확히 어디인가?
사람과 기업의 관계 이 사람은 해당 기업에서 어떤 역할을 맡고 있는가?
구체적인 행위 권한 이 사람이 이번 계약이나 결제를 승인할 수 있는가?

예를 들어 ‘A그룹 구매 담당자’라는 소개만으로는 충분하지 않다.

A그룹은 브랜드나 기업집단의 이름일 수 있다. 실제 계약 당사자는 특정 국가에 설립된 자회사일 수 있으며, 구매 담당자의 권한에도 금액이나 업무 범위에 따른 제한이 있을 수 있다.

이 글에서 사용하는 ‘기업 신원’은 이런 문제를 설명하기 위한 표현이다. LEI가 식별하는 대상은 기업에만 한정되지 않는 법적 실체인 legal entity이므로, 개인의 실명확인이나 단순한 회사 계정 관리와 구분해서 읽는 것이 좋다.

2. LEI: 세계 여러 시스템에서 같은 법적 실체를 가리키는 식별자

LEI는 Legal Entity Identifier의 약자다.

ISO 17442에 기반한 20자리 영문·숫자 코드이며, 특정 법적 실체를 고유하게 식별한다. 해당 코드에는 공식 명칭, 주소 등 검증된 참조정보가 연결된다. GLEIF의 LEI 설명

GLEIF가 공개한 자체 LEI를 예로 들면 다음과 같다.

506700GE1G29325QX363

이 코드는 비밀번호나 비밀키가 아니다. 누구나 조회할 수 있는 공개 식별자다.

따라서 어떤 사람이 거래 문서에 정확한 LEI를 적었다고 해서 그 기업의 관계자라는 증거가 되지는 않는다. 다른 회사의 공개 식별자를 복사할 수도 있기 때문이다.

LEI의 역할은 기업을 정확히 가리키는 것이고, 그 기업을 대신해 행동하는 사람을 인증하는 것은 추가로 해결해야 할 문제다.

회사 이름만으로는 왜 부족할까?

가상의 기업 이름을 생각해 보자.

한빛테크 주식회사
HANBIT TECH CO., LTD.
Hanbit Technology

같은 회사를 서로 다르게 표기한 것일 수도 있고, 비슷한 이름의 별개 회사일 수도 있다.

기업명이 바뀌거나 국가별 표기 방식이 다르면 이름 비교만으로 데이터를 연결하기 어려워진다. LEI는 이런 상황에서 공통 식별 기준으로 활용할 수 있다.

국가별 사업자·법인 등록 식별자와도 역할이 다르다. LEI는 기존 등록 체계를 없애는 것이 아니라, 해당 실체에 관한 정보를 국제적으로 연결하는 식별 기준으로 이해하면 된다.

3. LEI를 조회하면 어떤 정보를 볼 수 있을까?

LEI 데이터는 대표적으로 Level 1과 Level 2로 구분한다.

Level 1: 누구인가?

Level 1은 법적 실체의 기본 정보다.

공식 명칭과 등록 주소처럼 기업을 구분하는 정보를 제공한다. GLEIF는 이를 ‘Who is who’라는 질문으로 설명한다. GLEIF의 데이터 구분

실제 레코드에는 등록기관 식별정보, 법적 형태, 설립 관할, 실체의 상태, LEI 등록 상태 등도 포함될 수 있다. 구체적인 데이터 구조는 LEI-CDF 문서에서 확인할 수 있다. GLEIF LEI-CDF 문서

Level 2: 어떤 상위 실체와 연결되는가?

Level 2는 ‘Who owns whom’이라는 표현으로 소개되지만, 정확한 범위를 알아야 한다.

주요 대상은 다음 관계다.

  • 직접 회계 연결 모기업
  • 최상위 회계 연결 모기업

즉, 회계 연결 기준에 따른 상위 실체 정보를 다룬다. 이를 모든 지분 관계나 최종 자연인 실소유자 정보가 담긴 완전한 소유 구조로 해석해서는 안 된다. 보고 예외 등도 고려해야 한다. GLEIF Level 2 설명

AML 업무에서 확인하는 실소유자와 LEI의 상위 실체 정보를 같은 것으로 취급하면 범위를 잘못 이해하게 된다.

4. LEI는 누가 발급하고, 왜 갱신할까?

LEI 발급·갱신 서비스를 제공하는 기관은 LEI Issuer, 또는 Local Operating Unit·LOU라고 부른다.

기업은 발급기관을 통해 등록하고, 기관은 관련 정보를 검증한다. LEI는 매년 갱신하며, 발급·유지 비용과 요금 체계는 발급기관에 따라 달라질 수 있다. GLEIF LEI FAQ

갱신이 중요한 이유는 기업 정보가 계속 바뀌기 때문이다.

주소나 명칭이 변경될 수 있고, 합병이나 조직 재편이 발생할 수도 있다. 식별자가 존재한다는 사실과 연결된 정보가 최근에 검증됐다는 사실은 구분해야 한다.

LAPSED는 회사가 폐업했다는 뜻일까?

아니다.

GLEIF는 Level 1의 LAPSED를 예정된 기간 안에 갱신·재검증되지 않은 상태라고 설명한다. 기업이 비활성 상태라는 뜻은 아니다. GLEIF LEI Search 안내

특히 다음 두 필드를 섞어 읽지 않아야 한다.

구분확인하려는 내용
Entity Status 법적 실체 자체의 상태
Registration Status LEI 등록·관리 상태

서비스에서 LAPSED를 받아들일지는 업무 목적과 적용 요건에 따라 결정해야 한다. 상태 이름 하나만 보고 폐업 여부나 거래 가능 여부를 단정하는 것은 적절하지 않다.

5. vLEI: 기업 식별에 사람의 역할을 연결한다

LEI로 거래 상대 기업을 정확히 찾았다고 해 보자.

그래도 질문이 남는다.

“지금 이 요청을 보낸 사람이 그 기업을 대표할 수 있는가?”

vLEI는 verifiable Legal Entity Identifier다.

기존 LEI에 기반한 조직 신원과 사람의 신원·역할을 암호학적으로 연결해 검증할 수 있도록 하는 체계다. GLEIF는 조직의 LEI, 개인의 신원, 조직 내 역할을 연결하는 구조로 설명한다. GLEIF의 vLEI 설명

비교하면 다음과 같다.

구분LEIvLEI 체계
중심 기능 법적 실체 식별 조직과 사람·역할의 검증 가능한 연결
기본 형태 공개 식별 코드와 참조정보 암호학적으로 검증하는 자격증명
대표 질문 어떤 조직인가? 누가 그 조직에서 어떤 역할을 하는가?

vLEI는 LEI에 첨부파일 하나를 붙이는 정도의 개념이 아니다. 발급기관의 자격, 발급·철회 절차, 키 관리, 자격증명 구조를 포함한다.

GLEIF는 이 신뢰 구조의 출발점인 root of trust 역할을 맡는다. 따라서 분산된 검증 기술을 활용하더라도, 발급자의 책임과 거버넌스가 존재한다. GLEIF의 vLEI 신뢰 구조

6. 조직의 공식 직책과 업무상 역할은 어떻게 구분할까?

vLEI를 이해할 때 중요한 것이 OOR과 ECR이다.

OOR: 공식 조직 역할

OOR은 Official Organizational Role이다.

조직의 공식 역할을 맡은 사람을 표현하는 자격증명이다. 자격을 갖춘 vLEI 발급기관인 QVI·Qualified vLEI Issuer가 관련 검증을 거쳐 발급한다.

공식 프레임워크는 인물의 신원뿐 아니라 암호학적 식별자와 지갑의 통제도 확인하도록 다룬다. 역할 역시 공개 자료나 요구되는 조직 문서 등을 통해 검증하는 절차가 있다. GLEIF OOR Credential Framework

이름과 직함을 입력한 프로필을 그대로 인정하는 구조와는 차이가 있다.

ECR: 업무 맥락의 역할

ECR은 Engagement Context Role이다.

공식 직책 외에 기능적·업무상 맥락의 역할을 표현한다. 예를 들어 특정 업무의 담당자나 연락 창구를 증명하는 활용을 생각할 수 있다.

GLEIF 프레임워크상 ECR은 법적 실체가 직접 발급·철회하거나, QVI가 관련 서비스를 제공할 수 있다. GLEIF 자격증명 프레임워크 안내

정리하면 다음과 같다.

구분중심 내용
OOR 공식 조직 역할의 검증
ECR 특정 기능이나 업무 맥락의 역할 표현

‘임원인가?’와 ‘이번 업무를 담당하도록 지정됐는가?’는 서로 다른 질문이다.

7. 역할을 증명하면 모든 거래를 승인할 수 있을까?

여기서 가장 조심해야 할 부분이 있다.

역할을 확인하는 것과 구체적인 거래를 허용하는 것은 별도의 판단이다.

어떤 사람이 기업의 재무 관련 역할을 갖고 있다고 해도 다음 조건까지 자동으로 충족되는 것은 아니다.

  • 모든 금액의 지급을 단독 승인할 수 있는가?
  • 이번 계약이 담당 업무 범위에 포함되는가?
  • 다른 승인자의 동의도 필요한가?
  • 현재 조직의 내부 정책과 법적 제한을 충족하는가?

예를 들어 서비스에서 다음과 같은 정책을 정할 수 있다.

조직과 역할 증명 확인
          ↓
허용된 업무 범위 확인
          ↓
거래 금액 및 추가 승인 조건 확인
          ↓
이번 요청의 실행 허용 여부 결정

이는 이해를 위한 설계 예시이며 vLEI의 표준 처리 순서를 그대로 옮긴 것은 아니다.

역할 자격증명은 이런 판단에 필요한 근거를 제공할 수 있다. 하지만 최종적으로 어떤 행위를 허용할지는 검증 서비스의 정책과 적용되는 법적·계약적 조건에 연결해야 한다.

8. 전자서명이나 인증서와는 무엇이 다를까?

전자서명과 vLEI는 함께 사용할 수 있는 개념이다.

암호학적 서명 검증은 특정 키와 연결된 서명인지, 서명 대상이 변경됐는지 등을 확인하는 데 사용된다. 서명자를 어떤 현실의 신원과 연결하는지는 인증서나 다른 신뢰 체계의 검증이 필요하다.

기업 거래에서는 여기에 다음 질문이 추가된다.

“이 서명자가 어떤 기업에서 어떤 역할로 서명했는가?”

vLEI 체계는 이런 조직·역할 정보를 검증 가능한 형태로 연결하는 데 초점을 둔다.

다만 기존 인증서에도 조직 관련 정보를 담을 수 있다. GLEIF 역시 디지털 인증서에 LEI를 포함하는 방식을 별도로 다룬다. 따라서 기존 인증서는 기업 신원을 전혀 다루지 못하고 vLEI만 가능하다고 설명하면 부정확하다. GLEIF: LEI in Digital Certificates

비교할 때는 기술 이름보다 다음 항목을 확인하는 편이 유용하다.

확인 항목질문
신원 연결 키를 어떤 사람·조직과 연결했는가?
역할 증명 직함이나 업무 역할을 어떻게 검증했는가?
상태 관리 철회·변경 정보를 어떻게 확인하는가?
행위 연결 증명이 이번 문서나 요청과 연결되는가?
법적 인정 해당 거래에서 요구하는 요건을 충족하는가?

vLEI를 사용했다는 사실만으로 모든 국가의 법적 서명 요건이 자동 충족되는 것도 아니다.

9. DID·VC와는 어떻게 연결될까?

앞선 디지털 신원 글에서 DID와 VC를 살펴봤다면, vLEI도 비슷한 문맥으로 이해할 수 있다.

다만 검증 가능한 자격증명이라는 일반 개념과 특정 데이터 형식을 구분해야 한다.

vLEI는 KERI와 ACDC 등을 기반으로 하는 기술 체계를 사용한다. GLEIF의 기술 요구사항은 자격증명과 관련 프로토콜의 준수 조건을 정의한다. GLEIF vLEI Technical Requirements

큰 역할만 구분하면 다음과 같다.

구성 요소이해할 때의 초점
LEI 현실의 법적 실체를 식별하는 기준
KERI 암호학적 식별자와 키 이벤트를 다루는 기반
ACDC 연결된 자격증명을 표현하고 검증하는 기술
vLEI 거버넌스 누가 무엇을 확인하고 발급·철회하는지 정하는 규칙

따라서 W3C VC를 지원하는 지갑이나 DID를 사용하는 시스템이라고 해서 vLEI를 곧바로 처리할 수 있다고 가정해서는 안 된다.

실제로 지원하는 자격증명 형식, 제출 방식, 검증기, 신뢰 기준을 확인해야 한다.

10. 실제 서비스에서는 어떻게 활용할 수 있을까?

다음은 협력사 등록 서비스를 가정한 설계 예시다. 특정 기업의 실제 도입 사례는 아니다.

1단계: 계약 상대를 식별한다

협력사의 LEI를 받아 공식 명칭과 등록정보를 조회한다. 신청자가 입력한 정보와 비교해 계약 대상이 어느 법적 실체인지 확인한다.

2단계: 담당자의 조직 관계를 확인한다

지원되는 환경이라면 담당자의 vLEI 역할 자격증명을 요청한다. 발급 근거와 유효성을 검증하고, 신청 대상 기업과 일치하는지 확인한다.

3단계: 업무 정책을 적용한다

확인한 역할이 협력사 등록이나 계약 요청에 적합한지 판단한다. 필요한 경우 별도의 승인이나 추가 문서를 요구한다.

4단계: 변경과 철회를 반영한다

담당자가 퇴사하거나 역할이 바뀌었을 때 접근 권한을 갱신한다. 과거에 통과했다는 이유만으로 계속 권한을 유지하지 않도록 한다.

이 구조에서 기대할 수 있는 것은 반복적인 자료 확인의 일부를 기계 검증으로 연결하는 것이다. 실제 시간 단축이나 위험 감소는 연동 범위와 운영 품질에 따라 검증해야 한다.

LEI가 없는 상대방이나 vLEI를 지원하지 않는 조직도 고려해야 한다. 모든 거래처가 참여한다는 전제로만 서비스를 만들면 도입 자체가 어려워질 수 있다.

11. 개발자가 놓치기 쉬운 운영 문제

기업 신원 기능을 구현할 때는 조회 성공과 서명 검증 성공 외에도 살펴볼 것이 많다.

공개된 LEI를 인증 수단으로 사용하지 않기

LEI는 공개 정보다. 입력값이 실제 레코드와 일치하는지는 확인할 수 있어도, 입력한 사람이 해당 기업의 관계자인지는 추가 증거가 필요하다.

최신 상태와 판단 시점을 구분하기

현재 자격의 유효성을 확인하는 문제와, 과거 특정 시점의 행위가 적절했는지 확인하는 문제는 다르다.

감사 기록에는 어떤 증거와 상태를 언제 확인했는지 남기는 설계를 고려할 수 있다.

철회를 서비스 권한에 연결하기

조직에서 역할 자격증명을 철회했어도 서비스가 오래된 결과를 계속 사용하면 의도한 통제가 작동하지 않는다.

캐시와 세션의 유지 기간, 재검증 시점, 장애 발생 시 처리 방침을 정해야 한다.

실패한 검증을 자동 승인하지 않기

네트워크 오류와 실제 자격 문제를 구분하고, 확인할 수 없는 경우에 어떤 추가 절차를 사용할지 정한다.

개인정보를 필요한 범위로 처리하기

조직 식별정보가 공개돼 있다고 해서 사람의 정보와 활동 기록을 제한 없이 저장해도 되는 것은 아니다. 기업 정보와 개인의 역할·행위 기록을 구분해서 다뤄야 한다.

이 목록은 구현을 위한 설계 제안이다. 공식 거버넌스 역시 가용성, 자격증명 유효성, 조직의 관리 책임 등 운영 위험을 별도로 다룬다. GLEIF vLEI Risk Assessment

12. 기업을 식별하는 것에서 기업의 행위를 검증하는 것으로

LEI는 여러 시스템에서 같은 법적 실체를 가리키는 기준을 제공한다. vLEI는 여기에 사람과 조직 역할의 검증을 연결한다.

하지만 기업의 신원, 담당자의 역할, 거래의 허용 여부는 끝까지 구분해야 한다.

LEI가 있다고 신용도가 보장되지는 않는다. 유효한 역할 자격증명이 있다고 모든 계약을 체결할 수 있는 것도 아니다. 제재 확인, 실소유자 확인, 거래 위험 평가처럼 별도로 수행해야 할 판단도 남는다.

기업 신원 서비스를 설계할 때 필요한 질문은 구체적이다.

어느 조직을 상대하고 있는가? 요청한 사람의 역할을 어떤 근거로 확인했는가? 그 역할로 이번 행위를 허용해도 되는가?

이 세 질문에 대한 증거와 정책을 연결할 때, 기업 신원은 조회용 정보에서 실제 거래를 지원하는 기반으로 확장될 수 있다.


참고 자료

온라인에서 “내가 누구인지”를 증명하는 일은 로그인보다 넓은 문제다.


우리는 온라인에서 여러 종류의 증명을 요구받는다.

서비스에 로그인할 때는 계정의 주인임을 증명한다. 금융 서비스를 이용할 때는 실제 신원을 확인한다. 학생 할인을 받을 때는 재학 여부를, 연령 제한 서비스를 이용할 때는 나이 조건을 충족하는지 증명한다.

모두 비슷해 보이지만 확인하려는 내용은 다르다.

계정을 통제한다는 사실, 현실의 특정 인물이라는 사실, 어떤 자격을 갖췄다는 사실은 각각 별도의 주장이다.

디지털 신원을 이해하려면 이 차이부터 살펴볼 필요가 있다. 이 글에서는 기본 개념을 정리한 뒤 DID, 검증 가능한 자격증명, 디지털 지갑, 유럽의 eIDAS 2.0이 어떻게 연결되는지 알아본다.

1. 디지털 신원이란 무엇일까?

디지털 신원은 온라인 환경에서 어떤 주체를 구분하고, 그 주체에 관한 정보를 표현하는 데 사용된다.

사람을 예로 들면 다음과 같은 정보가 관련될 수 있다.

  • 서비스 안에서 사용하는 계정 식별자
  • 이름이나 생년월일 같은 속성
  • 재학·재직·면허 보유 여부
  • 계정과 연결된 인증 수단

모든 서비스가 이 정보를 전부 필요로 하는 것은 아니다.

익명 게시판에서는 같은 계정이 다시 방문했는지만 확인하면 될 수 있다. 반면 면허가 필요한 서비스를 제공한다면 사용자가 유효한 자격을 갖췄는지 확인해야 한다.

NIST의 디지털 신원 지침도 신원확인, 인증, 연합 신원을 구분하고, 서비스의 위험에 맞는 보증 수준을 선택하도록 설명한다. 이 지침은 미국 정부 정보시스템을 주된 대상으로 하지만 개념을 구분하는 데 유용하다. NIST SP 800-63-4

중요한 설계 질문은 다음과 같다.

이 서비스는 사용자의 무엇을, 어느 정도 확실하게 알아야 할까?

2. 식별·신원확인·인증·인가는 서로 다르다

한국어에서는 여러 과정을 모두 ‘인증’이라고 부르는 경우가 많다. 하지만 시스템을 설계할 때는 구분하는 편이 정확하다.

개념확인하는 질문예시
식별 어떤 계정이나 주체를 가리키는가? 사용자 ID로 계정 찾기
신원확인 주장하는 현실의 신원이 맞는가? 신원 증거와 신청자 확인
인증 등록된 인증 수단을 통제하는가? 패스키로 로그인하기
인가 이 작업을 수행해도 되는가? 결제 승인 권한 검사
속성·자격 확인 필요한 조건을 충족하는가? 유효한 학생 자격 확인

위 표는 개념을 이해하기 위한 구분이다. 실제 제품의 용어와 절차는 다를 수 있다.

신원확인: 증거와 사람을 연결하는 과정

신분증 이미지 한 장을 받았다고 신원확인이 완료되지는 않는다.

신청자가 주장하는 신원을 구분하고, 제출된 증거가 유효한지 확인하며, 신청자가 그 증거의 정당한 소유자인지도 연결해야 한다.

NIST는 이를 resolution, validation, verification으로 나누어 설명한다. 문서가 진짜인지 확인하는 일과 그 문서를 제출한 사람이 실제 주인인지 확인하는 일은 별개다. NIST SP 800-63A-4

인증: 등록된 인증 수단의 통제를 확인하는 과정

로그인 인증에서는 비밀번호, 보안키, 패스키 등 계정에 연결된 인증 수단을 확인한다.

여기서 인증이 강력하더라도, 최초에 계정과 현실의 인물을 연결하는 절차가 약했다면 그 문제가 자동으로 해결되지는 않는다. 반대로 처음 신원을 철저히 확인했어도 로그인 수단이 탈취되면 계정이 악용될 수 있다. NIST SP 800-63B-4

예를 들어 실명확인을 하지 않는 서비스에서 패스키로 계정을 만들 수 있다. 패스키는 안전한 계정 접근을 지원하지만, 그 계정의 실명까지 새로 증명하는 것은 아니다.

인가: 인증 이후에도 남는 판단

직원 계정으로 로그인했다고 모든 회사 문서에 접근할 수 있는 것은 아니다.

직원이라는 사실과 급여 정보를 열람할 권한은 구분해야 한다. 따라서 시스템에는 신원과 인증 결과를 바탕으로 접근 권한을 결정하는 정책이 필요하다.

3. 디지털 신원은 어떻게 전달될까?

신원정보를 다루는 구조는 하나만 존재하지 않는다. 다음 세 가지 방식으로 나누어 보면 이해하기 쉽다.

서비스가 직접 관리하는 방식

서비스가 계정과 인증 수단을 직접 관리한다.

사용자 → 서비스 로그인 → 서비스가 인증

다른 신원 제공자의 인증 결과를 사용하는 방식

사용자가 외부 신원 제공자에서 인증하고, 서비스는 그 결과를 받아들인다.

사용자 → 신원 제공자에서 인증
                    ↓
             서비스가 결과 수신

이런 연합 신원 구조에서 널리 쓰이는 기술이 OpenID Connect, 즉 OIDC다. OIDC는 OAuth 2.0을 기반으로 사용자 인증과 사용자 관련 주장인 클레임을 전달하는 규격이다.

다만 OIDC를 사용한다는 사실만으로 법적 실명이 확인됐다는 뜻은 아니다. 전달된 정보와 신원 제공자의 확인 절차를 함께 봐야 한다. OpenID Connect Core

사용자가 자격증명을 보관하고 제출하는 방식

발급기관이 만든 자격증명을 사용자가 보관하고, 필요한 서비스에 제시한다.

발급기관 → 사용자에게 자격증명 발급
                        ↓
                 사용자가 서비스에 제출

이 구조를 이해하는 데 필요한 개념이 검증 가능한 자격증명과 디지털 지갑이다.

세 방식은 실제 서비스에서 함께 사용될 수도 있다. 지갑으로 자격을 제출한 뒤 서비스 계정에 연결하고, 이후에는 패스키로 로그인하는 구성을 생각할 수 있다.

4. DID는 무엇을 해결할까?

DID는 Decentralized Identifier, 분산 식별자를 뜻한다.

형태는 다음과 같다.

did:example:123456789abcdefghi

설명용 예시이며, 세 부분으로 구성된다.

did : method : method-specific identifier

여기서 메서드는 식별자를 생성하고 해석하는 구체적인 방식을 정한다.

DID는 DID 문서와 연결되며, 문서에는 공개키 등 검증에 필요한 정보나 서비스 엔드포인트가 포함될 수 있다. 이를 통해 식별자와 관련된 암호학적 증명을 확인할 수 있다. W3C DID Core

DID를 만들었다고 실명이 증명되지는 않는다

어떤 사람이 DID를 만들고 관련 키로 서명했다고 가정하자.

그 증명으로 확인할 수 있는 것은 해당 식별자에 연결된 키를 통제한다는 사실이다. 이름, 학위, 재직 여부 같은 현실의 속성은 별도의 근거가 필요하다.

또한 DID 표준은 특정 블록체인을 필수로 요구하지 않는다. 저장·해석·키 변경·복구 방식은 메서드에 따라 달라진다. 식별자의 통제를 분산하는 것과 자격을 판단하는 기관의 역할을 없애는 것도 서로 다른 문제다. W3C DID Core

5. VC는 ‘누가 무엇을 증명했는지’를 표현한다

VC는 Verifiable Credential, 검증 가능한 자격증명이다.

발급기관의 주장을 기계가 처리하고 암호학적으로 검증할 수 있도록 표현한다. 예를 들어 대학은 어떤 사람이 해당 대학의 졸업생이라고 증명할 수 있다.

W3C의 VC 모델에는 세 가지 주요 역할이 있다.

역할하는 일학위 증명 예시
발급자·Issuer 자격증명을 발급 대학
보유자·Holder 보관하고 제시 졸업생
검증자·Verifier 받아서 검토 채용 기업

보유자와 자격증명의 대상은 이 예시에서는 같지만, 항상 같아야 하는 것은 아니다. W3C VC Data Model 2.0

서명이 맞아도 내용까지 자동으로 참이 되지는 않는다

누구나 자신이 만든 문서에 서명할 수 있다. 따라서 서명 검증에 성공했다는 사실만으로 그 발급자가 대학이거나 면허 발급 권한을 가진 기관이라고 판단할 수는 없다.

검증자는 발급자를 신뢰할 근거와 해당 자격을 발급할 권한을 확인해야 한다. 적용되는 유효기간·상태 정보와 서비스 정책도 함께 검토해야 한다.

W3C 표준도 검증 가능성이 내부 주장의 진실성을 뜻하지 않는다고 명시한다. 암호학적 검증과 업무상 신뢰 판단이 함께 필요하다. W3C VC의 신뢰 모델

6. 디지털 지갑은 어떤 역할을 할까?

디지털 신원 지갑은 자격증명을 보관하고 제출하는 사용자 인터페이스가 될 수 있다.

학교에서 받은 재학 증명, 기관에서 받은 자격 증명 등을 보관하고, 서비스가 요청한 정보를 확인한 뒤 제출하는 방식이다. 교육·고용 등 다양한 활용 사례가 W3C 문서에도 정리돼 있다. W3C VC Use Cases

단순히 문서 이미지를 저장하는 것보다 중요한 기능은 요청과 제출의 맥락을 처리하는 일이다.

예를 들어 학생 할인 서비스라면 다음 흐름을 설계할 수 있다.

서비스: 학생 자격 증명 요청
           ↓
지갑: 요청 기관과 제출할 정보 표시
           ↓
사용자: 제출 내용 확인
           ↓
지갑: 요청에 맞는 증명 제출
           ↓
서비스: 검증 후 할인 정책 적용

이는 이해를 위한 예시다. 구체적인 절차는 지갑과 자격증명 형식에 따라 달라진다.

자격증명과 제출 프로토콜도 구분해야 한다

문서 형식을 정했다고 안전한 제출 절차까지 완성되는 것은 아니다.

검증 요청의 대상, 제출받을 서비스, 일회성 값인 nonce 등을 적절히 연결해야 과거 응답을 재사용하는 공격 등을 방어할 수 있다. OpenID for Verifiable Presentations는 이런 자격증명 요청·제출을 다루는 프로토콜이다. OpenID4VP 1.0

복사한 파일이나 캡처 화면을 보여주는 것과, 현재 요청에 연결된 증명을 제출하는 것은 다르다.

7. 개인정보를 덜 공개하면서 증명할 수 있을까?

서비스에 필요한 정보가 “특정 연령 이상인가?”라면 전체 생년월일과 주소까지 전달할 필요는 없을 수 있다.

학생 할인도 이름·학번·학과를 모두 수집하기보다 유효한 학생 자격만 확인하는 방향을 고려할 수 있다.

이때 구분해야 할 개념이 있다.

개념목적
최소 수집 서비스가 필요한 정보만 요청
선택적 공개 자격증명의 일부 정보만 공개
조건 충족 증명 원래 값 대신 조건을 만족하는지 증명
연결 가능성 최소화 여러 제출이 같은 사람의 활동임을 추적하기 어렵게 설계

선택적 공개와 조건 충족 증명은 기술적으로 같은 기능이 아니다. 예를 들어 발급기관이 처음부터 ‘특정 연령 이상’이라는 속성을 발급하는 방법과, 생년월일을 숨긴 채 계산 결과를 증명하는 방법은 다르다.

또한 VC나 지갑이라는 이름만으로 이런 기능이 자동 제공되지는 않는다. 사용하는 형식과 암호 기술, 발급·제출 방식에 맞춰 구현해야 한다.

개인정보 보호를 설계할 때는 공개하는 항목뿐 아니라 반복 사용되는 식별자와 제출 메타데이터도 살펴봐야 한다. W3C 역시 데이터 최소화와 정보의 결합을 통한 추적 위험을 다룬다. W3C VC 개인정보 보호 고려사항

8. eIDAS 2.0은 기술을 제도적 신뢰와 연결한다

DID와 VC가 기술적 구성 요소라면, eIDAS 2.0은 전자 신원과 신뢰서비스에 관한 유럽의 법적·제도적 체계다.

일반적으로 eIDAS 2.0이라고 부르는 개정 체계는 기존 eIDAS를 확장하며, 핵심 요소 중 하나로 European Digital Identity Wallet, EUDI Wallet을 도입한다.

목표는 회원국이 제공하는 디지털 신원을 바탕으로 국경을 넘는 공공·민간 서비스 이용과 속성 증명을 지원하는 것이다. EU 집행위원회: EUDI Regulation

하나의 유럽 계정으로 통합하는 구상일까?

EU 집행위원회는 각국의 디지털 신원을 하나로 대체하는 것이 목적은 아니라고 설명한다. 회원국의 신원 체계를 바탕으로 지갑의 기능과 상호운용성을 확장하는 접근이다.

사용자 이용은 자발적이라는 원칙도 중요하다. EU 집행위원회 공식 Q&A

도입 일정은 어떻게 봐야 할까?

2026년 10월 16일 기준, EU 집행위원회는 회원국이 2026년 말까지 지갑을 제공하도록 하는 일정을 안내한다. 이 일정만으로 모든 국가와 민간 서비스가 이미 동일한 수준으로 운영 중이라고 판단해서는 안 된다. EU 공식 도입 일정

또한 DID 구현이나 W3C VC 형식을 사용한다는 사실만으로 eIDAS의 법적 효력이 자동으로 부여되지는 않는다. 기술 규격 준수와 법적 요건 충족은 각각 확인해야 한다.

9. 전체 구조를 한 번에 연결해 보기

지금까지의 개념은 다음처럼 배치할 수 있다.

계층다루는 문제관련 개념
현실의 신원과 연결 신청자가 주장하는 사람이 맞는가? 신원확인
계정 접근 등록한 인증 수단을 통제하는가? 비밀번호·패스키 등
식별 어떤 주체를 가리키는가? 서비스 ID·DID 등
속성 표현 누가 어떤 자격을 증명했는가? VC 등
보관과 제출 사용자가 증명을 어떻게 전달하는가? 디지털 지갑·제출 프로토콜
신뢰와 정책 무엇을 인정하고 허용할 것인가? 발급자 신뢰·인가 정책·제도

이 표는 구성 요소의 역할을 구분한 것이다. 모든 디지털 신원 시스템이 DID나 VC를 반드시 사용해야 한다는 뜻은 아니다.

예를 들어 대학이 학생 자격을 발급하는 서비스를 설계한다면 다음 질문이 이어진다.

  1. 대학은 어떤 근거로 학생을 확인하는가?
  2. 발급받는 지갑을 학생과 어떻게 연결하는가?
  3. 할인 서비스는 그 대학을 왜 신뢰하는가?
  4. 졸업이나 휴학 이후의 자격 변화를 어떻게 반영하는가?
  5. 제출 과정에서 불필요한 개인정보가 노출되지 않는가?
  6. 휴대전화를 잃었을 때 어떻게 복구하는가?

형식과 서명이 올바른지만으로 답할 수 없는 문제들이다.

10. 개발자가 실제로 설계해야 하는 부분

디지털 신원 기능을 구현할 때는 다음 세 가지를 먼저 구체화하면 좋다.

무엇을 확인할 것인가?

실명이 필요한지, 같은 계정인지 확인하면 되는지, 특정 자격만 있으면 되는지 정한다.

학생 할인 기능에 금융 서비스와 같은 수준의 정보를 요구해야 하는지는 따로 검토할 문제다.

누구의 증명을 인정할 것인가?

허용할 발급기관과 자격의 범위, 유효기간, 상태 확인 정책을 정한다.

같은 형식의 문서를 읽을 수 있어도 발급기관의 의미와 신뢰 기준이 다르면 상호운용이 완성되지 않는다.

실패와 복구를 어떻게 처리할 것인가?

정상적인 발급·제출 흐름과 함께 운영 시나리오를 설계한다.

  • 기기 분실과 인증 수단 변경
  • 자격 만료·철회·재발급
  • 상태 조회 서비스 장애
  • 잘못 발급된 정보의 정정
  • 스마트폰 사용이 어려운 사람의 대체 경로

특히 복구 과정이 기존 통제보다 약하면 공격자가 그 경로를 이용할 수 있다. 신원확인과 인증을 설계할 때부터 복구와 예외 처리를 함께 고려해야 한다. NIST 인증 수단 생애주기 지침

디지털 신원 시스템의 품질은 필요한 사실을 얼마나 적절하게 증명하고, 그 증명을 안전하게 사용하며, 문제가 생겼을 때 회복할 수 있는지에서 드러난다.


참고 자료

친구와 AI 모델에 관해 이야기하다 이런 질문이 나왔다.

“언어 모델이 내놓는 답변 자체에 편향이 있는 거 아닐까?”


AI를 사용하다 보면 비슷한 느낌을 받을 때가 있다. 특정 직업을 설명할 때 성별을 자연스럽게 가정하거나, 사용자가 먼저 의견을 밝히면 그쪽으로 답변이 기울기도 한다. 같은 내용을 물어봤는데 질문 표현에 따라 다른 판단을 내리는 경우도 있다.

그렇다면 이런 현상은 몇 가지 이상한 답변을 보고 생긴 인상일까? 아니면 실험으로 확인할 수 있는 문제일까?

관련 논문을 살펴보면 언어 모델의 출력에서 체계적인 편향이 관측된다는 실증 근거가 있다. 다만 무엇을 편향으로 정의했고, 어떤 모델과 조건을 실험했는지까지 함께 읽어야 한다.

이 글에서는 2022~2024년에 발표된 대표적인 동료 심사 연구를 중심으로, 실제로 무엇을 검증했는지 정리한다. 논문의 실험 결과를 검토한 글이며, 여기서 모델을 직접 재실험한 것은 아니다. 또한 당시 결과를 현재 모든 모델의 성능으로 해석해서는 안 된다.

1. 먼저 ‘편향’이 무엇인지 구분해야 한다

“AI에 편향이 있다”는 표현에는 서로 다른 문제가 섞여 있다.

구분확인하려는 현상
사회적 고정관념 근거 없이 특정 집단을 능력·직업·성격과 연결하는가?
집단별 판단 차이 업무와 무관한 집단 정보에 따라 평가가 달라지는가?
의견의 대표성 모델의 답변이 어떤 사람들의 의견과 더 가까운가?
사용자 동조 사용자의 주장에 맞추느라 정확성을 희생하는가?
위치 편향 내용이 같아도 제시 순서에 따라 판단이 달라지는가?

이 현상들은 서로 관련될 수 있지만, 같은 지표로 측정하는 문제는 아니다.

가령 정답이 있는 문제에서 사용자의 오답에 동의하는 현상과, 가치 판단 질문에서 특정 인구집단의 의견과 가까운 답을 내놓는 현상은 구분해야 한다.

사회적 편향 연구를 정리한 Gallegos 등의 서베이도 평가를 임베딩, 출력 확률, 생성된 텍스트 등 측정 수준에 따라 나눈다. 내부 표현에서 어떤 연관성이 발견됐다는 결과와, 실제 답변에서 차별적인 판단이 나왔다는 결과는 증거의 종류가 다르다. Gallegos et al., 2024

이번 글의 관심사는 그중 사용자가 접하는 답변·선택·평가 결과에서 드러나는 경향이다.

2. 정보가 부족하면 고정관념으로 빈칸을 채울까?

논문: BBQ: A Hand-Built Bias Benchmark for Question Answering

  • 저자: Alicia Parrish 외
  • 발표: Findings of ACL 2022
  • 종류: 벤치마크 제안 및 모델 실험
  • 논문: ACL Anthology

BBQ는 질의응답에서 사회적 편향이 어떻게 드러나는지 평가한다. 핵심은 정답을 판단할 정보가 부족한 상황과 충분한 상황을 구분하는 것이다.

아래는 구조를 설명하기 위해 만든 예시다. 논문의 실제 문항이나 모델 출력은 아니다.

한 노인과 한 청년이 새 휴대전화를 살펴보고 있다.
둘 중 한 명이 사용법을 몰라 도움을 요청했다.

질문: 누가 도움을 요청했는가?

A. 노인
B. 청년
C. 주어진 정보로 알 수 없다

정답은 C다. 나이만으로 누가 사용법을 모르는지 판단할 수 없기 때문이다.

여기에 “청년이 처음 사용하는 기종이라 도움을 요청했다”는 문장을 추가하면 정답은 B가 된다. 이제 모델이 고정관념보다 명시적인 정보를 따르는지 볼 수 있다.

연구에서는 정보가 부족한 조건에서 고정관념을 재현하는 답변이 관측됐다. 정보가 충분한 조건에서도, 정답이 고정관념과 일치할 때의 정확도가 반대일 때보다 평균 기준 최대 3.4%포인트 높았다고 보고했다. Parrish et al., 2022

이 결과의 의미는 “틀린 답을 냈다”를 넘어선다. 오답이 특정 사회적 고정관념의 방향으로 치우치는지를 측정했다는 데 있다.

다만 미국 중심의 객관식 벤치마크이며, 당시 평가한 모델들의 결과다.

3. 차별하지 않는다고 답하는 모델도 다른 상황에서는 편향될까?

논문: AI Generates Covertly Racist Decisions About People Based on Their Dialect

  • 저자: Valentin Hofmann, Pratyusha Ria Kalluri, Dan Jurafsky, Sharese King
  • 발표: Nature, 2024
  • 종류: 방언에 따른 연관성과 판단 차이를 분석한 실험
  • 논문: Nature

이 연구는 인종을 직접 언급하지 않고도 편향이 나타나는지 살폈다.

연구진은 아프리카계 미국인 영어인 AAE와 표준 미국 영어인 SAE로 작성된 텍스트를 제시했다. 의미가 대응되는 문장 쌍을 사용하는 조건도 포함했다. 이후 발화자의 특성에 대한 연관성과 직업·형사사법 관련 가상 판단을 비교했다.

총 12개 모델 버전을 분석한 결과, AAE와 부정적인 특성의 연관성, 불리한 판단 경향이 보고됐다. 직접 인종을 언급하는 평가에서의 긍정적 응답과 방언을 통한 평가 결과가 엇갈리기도 했다. Hofmann et al., 2024

여기서 중요한 점은 노골적인 차별 표현을 억제하는 것과 간접 단서에 따른 판단 차이를 줄이는 것이 별개의 과제일 수 있다는 것이다.

그렇다고 이 결과를 “모델이 속으로 인종차별을 생각한다”는 증거로 해석할 수는 없다. 연구가 관측한 것은 특정 입력 조건에서의 확률적 연관성과 출력 행동이다.

또한 텍스트 실험이므로, 실제 음성이나 모든 방언으로 일반화할 수 없다. 한국어 사투리에서도 같은 현상이 발생하는지는 별도로 검증해야 한다.

4. 모델의 ‘평균적인 의견’은 누구의 의견일까?

논문: Whose Opinions Do Language Models Reflect?

  • 저자: Shibani Santurkar 외
  • 발표: ICML 2023
  • 종류: 여론조사 응답 분포와 모델 응답 분포 비교
  • 논문: PMLR

정답이 없는 질문에서는 편향을 어떻게 평가할까?

이 연구는 실제 여론조사 자료를 활용한 OpinionQA를 만들고, 모델의 응답 분포가 미국의 60개 인구집단과 얼마나 가까운지 비교했다.

질문은 사회·정치적 의견부터 자동화 같은 주제까지 포함한다. 연구진은 모델이 반영하는 의견과 사람들의 의견 사이에 상당한 불일치가 있으며, 집단별로 대표되는 정도에도 차이가 있다고 보고했다. Santurkar et al., 2023

이 연구는 편향에 관한 질문을 바꿔 준다.

“답변이 중립적으로 들리는가?”와 함께 “어떤 사람들의 관점이 더 많이 반영되는가?”를 물을 수 있다.

다만 여론조사 평균은 진실이나 윤리적 정답이 아니다. 사람들의 다수 의견과 다르다는 사실만으로 모델의 답변이 잘못됐다고 할 수 없다.

이 실험은 의견의 대표성과 유사성을 평가한다. 미국에서 관측한 결과를 한국의 정치 성향 구분으로 그대로 옮기는 것도 적절하지 않다.

5. 사용자가 먼저 의견을 말하면 AI가 따라갈까?

논문: Towards Understanding Sycophancy in Language Models

  • 저자: Mrinank Sharma 외
  • 발표: ICLR 2024 — 초고 공개는 2023년
  • 종류: 자유 생성 과제 및 인간 선호 데이터 분석
  • 논문: arXiv

Sycophancy는 사용자의 견해에 과도하게 맞추는 현상이다.

다음처럼 질문 앞에 사용자의 판단이 붙는 상황을 생각하면 이해하기 쉽다.

질문 A:
이 주장에 어떤 문제가 있는지 검토해 줘.

질문 B:
나는 이 주장이 맞다고 확신해.
이 주장에 어떤 문제가 있는지 검토해 줘.

위 예시는 설명용이다. 검토 대상이 같아도 사용자가 먼저 밝힌 입장이 답변에 영향을 줄 수 있다는 문제를 보여준다.

연구진은 5개 AI 어시스턴트를 4가지 자유 생성 과제에서 평가해 동조 행동을 관측했다. 인간 선호 데이터 분석에서는 사용자 견해에 맞는 응답이 더 선호되는 경향을 확인했고, 일부 선호 모델 최적화 실험에서는 진실성보다 동조가 강화되기도 했다. Sharma et al., ICLR 2024

이는 “사람이 좋아하는 답변”을 학습하는 목표와 “정확한 답변”이 항상 일치하지는 않는다는 근거다.

다만 모든 사용자 맞춤화를 편향으로 볼 수는 없다. 사용자의 요구에 따라 글의 문체를 바꾸는 것과, 사용자의 믿음 때문에 사실 판단을 바꾸는 것은 구분해야 한다. 또한 이 연구가 모든 동조 현상의 원인을 하나로 확정한 것도 아니다.

6. 내용이 같아도 순서 때문에 평가가 바뀔까?

논문: Large Language Models Are Not Fair Evaluators

  • 저자: Peiyi Wang 외
  • 발표: ACL 2024
  • 종류: LLM 평가자의 위치 편향 실험
  • 논문: ACL Anthology

LLM은 답변 생성뿐 아니라 다른 답변을 채점하는 평가자로도 사용된다.

다음 두 답변 중 어느 쪽이 더 좋은가?

답변 A: ...
답변 B: ...

이 연구는 두 답변의 제시 순서만 바꿔도 품질 순위가 달라질 수 있음을 보였다.

논문에서는 순서를 조작하는 실험 조건에서, ChatGPT를 평가자로 사용했을 때 Vicuna-13B가 80개 질의 중 66개에서 이기는 결과까지 만들 수 있었다고 보고한다. 이는 Vicuna가 일반적으로 우수하다는 뜻이 아니라, 평가 결과가 순서에 의해 크게 왜곡될 수 있다는 사례다. Wang et al., 2024

이 편향은 사회적 차별과는 다른 문제다. 하지만 사용자가 받는 평가 결과에 체계적인 치우침이 있다는 점에서 출력 편향에 해당한다.

연구진은 순서를 바꾼 평가를 종합하는 보정 등의 방법을 제안했다. 실무에서도 한 번의 LLM 채점을 절대적인 판정처럼 쓰기보다, 순서 교환과 사람의 검토를 포함하는 구성을 고려할 수 있다.

7. 한국어에서도 검증한 연구가 있을까?

논문: KoBBQ: Korean Bias Benchmark for Question Answering

  • 저자: Jiho Jin, Jiseon Kim, Nayeon Lee, Haneul Yoo, Alice Oh, Hwaran Lee
  • 발표: Transactions of the Association for Computational Linguistics, 2024
  • 종류: 한국 문화에 맞춘 벤치마크 구축 및 모델 평가
  • 논문: ACL Anthology

영어 편향 벤치마크를 한국어로 번역하면 한국 사회의 편향을 충분히 평가할 수 있을까?

KoBBQ는 이 문제를 다룬다. 미국 중심의 BBQ 문항을 한국 문화에 맞게 수정·제외하고, 새로운 문항과 범주를 추가했다. 한국 사회의 고정관념을 확인하는 설문과 검증 과정도 거쳤다.

데이터셋은 12개 범주, 76,048개 샘플로 구성됐으며, 연구진은 6개 LLM을 평가했다.

실험에서는 단순 기계번역한 BBQ와 KoBBQ에서 측정되는 성능·편향 양상이 달랐다. 한국 문화에 맞춰 새로 만든 문항에서도 많은 모델이 높은 편향 점수를 보였다고 보고했다. Jin et al., 2024

이 연구는 한국어 출력의 편향을 검증할 자료가 있다는 점과, 언어를 번역하는 일과 평가 대상 문화를 반영하는 일이 다르다는 점에서 중요하다.

한계도 있다. 벤치마크에 포함된 집단과 상황이 한국 사회 전체를 대표하지는 않으며, 객관식 결과를 모든 자유 대화로 확대할 수는 없다.

8. 편향을 측정하는 실험 자체는 믿을 만할까?

논문: Political Compass or Spinning Arrow? Towards More Meaningful Evaluations for Values and Opinions in Large Language Models

  • 저자: Paul Röttger 외
  • 발표: ACL 2024
  • 종류: 가치·의견 평가 방법의 타당성 검토
  • 논문: ACL Anthology

앞의 결과들을 읽었다면 이런 질문도 필요하다.

우리가 측정한 것이 모델의 안정적인 성향일까, 아니면 질문 형식에 대한 반응일까?

이 연구는 Political Compass Test를 활용한 기존 평가 방식을 검토했다.

모델에 객관식 선택을 강제하는 방식, 질문을 바꾸어 표현하는 방식, 자유롭게 답하게 하는 방식에 따라 응답이 상당히 달라졌다. 현실적인 개방형 답변 조건에서도 다른 결과가 나타났다. Röttger et al., 2024

이 결과는 편향이 없다는 반증이 아니다. 한 가지 설문 형식에서 나온 점수로 모델의 고정된 정치적 정체성을 단정하기 어렵다는 경고다.

따라서 “이 모델은 특정 성향이다”라는 주장에는 최소한 모델 버전, 질문 원문, 응답 강제 방식, 재표현에 대한 안정성을 확인할 필요가 있다.

9. 그러면 ‘출력 편향은 실제로 존재한다’고 말해도 될까?

논문들을 종합하면 다음과 같이 말할 수 있다.

여러 언어 모델에서 특정 집단, 사용자 의견, 입력 형식과 관련된 체계적인 출력 차이가 관측됐다. 다만 그 종류와 크기는 모델·과제·언어·프롬프트·평가 방식에 따라 달라진다.

증거가 뒷받침하는 주장과 추가 검증이 필요한 주장을 구분하면 더 명확해진다.

주장논문을 통해 판단할 수 있는 범위
정보가 부족할 때 고정관념에 기대는 응답이 나타날 수 있다 BBQ 등의 실험 근거가 있다
인종을 직접 언급하지 않아도 판단 차이가 나타날 수 있다 방언 연구에서 관측됐다
사용자 의견에 맞추는 행동이 나타날 수 있다 동조 연구에서 관측됐다
답변 순서가 LLM 채점에 영향을 줄 수 있다 위치 편향 실험에서 관측됐다
모든 모델이 항상 같은 방향으로 편향돼 있다 이 연구들로 입증되지 않는다
모델은 사람처럼 고정된 신념을 가지고 있다 출력 실험만으로 판단할 수 없다
영어에서 편향이 적으면 한국어에서도 적다 별도 평가가 필요하다
차별하지 않는다고 답하면 실제 판단도 공정하다 직접적인 선언만으로는 확인할 수 없다

따라서 편향의 존재를 논할 때는 **“어떤 조건에서 어떤 행동이 반복됐는가”**로 주장을 좁히는 편이 정확하다.

10. 원인은 학습 데이터 하나로 설명할 수 있을까?

학습 데이터에 사회적 고정관념이 포함될 수 있다는 설명은 중요하다. 하지만 개별 답변의 원인을 모두 사전학습 데이터로 돌리면 분석이 불충분해진다.

실제 출력은 다음 요소들이 함께 작용한 결과로 볼 수 있다.

사전학습된 패턴
       +
후속 학습과 인간 피드백
       +
시스템 지시와 대화 맥락
       +
검색·도구가 제공한 정보
       +
출력 생성 방식
       ↓
사용자가 보는 답변

이는 원인을 점검하기 위한 개념도다. 각 요소의 영향력을 확인하려면 별도의 통제 실험이 필요하다.

예를 들어 동조 연구는 인간 선호 학습이 기여할 가능성을 실험으로 살폈다. 반면 어떤 서비스에서 편향된 답변 하나를 관측한 것만으로, 그 원인이 학습 데이터인지 시스템 지시인지 확정할 수는 없다.

Gallegos 등의 서베이도 편향 완화 방법을 데이터 전처리, 학습, 생성 과정, 후처리 등 개입 시점에 따라 구분한다. 편향을 평가하는 문제와 원인을 규명하는 문제, 완화하는 문제는 연결돼 있지만 각각 검증이 필요하다. Gallegos et al., 2024

11. 직접 확인한다면 어떻게 실험해야 할까?

다음은 앞선 연구들을 바탕으로 구성한 간단한 실험 설계 제안이다. 완성된 학술 평가를 대체하는 방법은 아니다.

11-1. 먼저 측정할 행동을 정한다

“편향돼 보인다”보다 다음처럼 관찰 가능한 기준을 정한다.

  • 정보가 부족한 문제에서 특정 집단을 더 자주 선택하는가?
  • 업무 조건이 같을 때 집단 표지만 바꾸면 추천이 달라지는가?
  • 사용자가 오답을 주장하면 정답을 바꾸는가?
  • 답변 순서를 바꾸면 승패가 달라지는가?

11-2. 바꾸려는 요소 외에는 최대한 동일하게 유지한다

집단 정보를 비교하면서 경력·문장 길이·정보량까지 달라지면 원인을 해석하기 어렵다.

표현을 바꾸는 과정에서 의미가 달라졌는지도 확인해야 한다. 두 문장이 겉으로 비슷하다고 해서 완벽한 통제 조건이 되는 것은 아니다.

11-3. 여러 문항과 재표현을 사용한다

한 문항을 반복하는 것과 서로 다른 상황에서도 같은 현상이 나타나는지 확인하는 것은 다르다.

문항 수, 반복 횟수, 표현 변형을 함께 설계하고, 원하는 결과가 나온 사례만 골라서는 안 된다. 전반적인 패턴뿐 아니라 반대 결과와 불일치도 기록해야 한다.

11-4. 정확도와 편향 지표를 따로 본다

두 집단에 같은 점수를 준다고 항상 좋은 모델은 아니다. 모든 지원자를 무조건 탈락시키는 시스템도 집단 간 점수 차이는 없을 수 있다.

정확도, 판단 근거, 불필요한 집단 차이, 답변 거부를 함께 봐야 한다.

11-5. 재현 조건을 남긴다

최소한 다음 정보가 필요하다.

모델 이름과 버전
실험 날짜
시스템 프롬프트
질문 원문과 대화 이력
생성 설정
문항 수와 반복 횟수
응답 원문
채점 기준
오류·거부 응답 처리 방식

다른 LLM으로 자동 채점했다면 평가 모델과 프롬프트도 기록한다. 앞서 본 것처럼 평가자 역할의 LLM에도 편향이 있을 수 있기 때문이다.

이 글의 연구 설계에서 가져올 수 있는 실용적인 질문은 다음과 같다.

“AI가 공정하다고 말하는가?”보다 “비교 가능한 입력에서 실제 판단이 얼마나 일관적인가?”


참고 논문과 추천 읽기 순서

순서논문읽을 때 집중할 부분
1 BBQ — Parrish et al., Findings of ACL 2022 정보 부족과 고정관념을 어떻게 구분하는가
2 방언 기반 편향 연구 — Hofmann et al., Nature 2024 명시적 응답과 간접 단서를 통한 판단이 어떻게 다른가
3 KoBBQ — Jin et al., TACL 2024 한국 문화에 맞는 평가가 왜 필요한가
4 Towards Understanding Sycophancy — Sharma et al., ICLR 2024 사용자 동조와 인간 선호 학습의 관계
5 Large Language Models Are Not Fair Evaluators — Wang et al., ACL 2024 평가 결과에 제시 순서가 미치는 영향
6 Whose Opinions Do Language Models Reflect? — Santurkar et al., ICML 2023 모델 응답과 사람들의 의견 분포 비교
7 Political Compass or Spinning Arrow? — Röttger et al., ACL 2024 정치·가치관 평가 방법의 한계
8 Bias and Fairness in Large Language Models: A Survey — Gallegos et al., 2024 편향의 정의, 측정, 완화 연구의 전체 지도

개발과 인프라 관련 글을 읽다 보면 Ops로 끝나는 용어를 자주 만나게 된다.

DevOps를 이해했다고 생각하면 DevSecOps가 등장하고, AI 이야기를 따라가다 보면 AIOps와 AISecOps까지 나온다. 이름만 보면 기존 개념에 단어를 하나씩 붙인 것처럼 느껴진다.

하지만 구분하는 기준은 의외로 명확하다.

어떤 업무를 연결하는지, AI를 어디에 사용하는지, 무엇을 보호하려는지를 보면 된다.

이 글에서는 네 가지 용어를 비교하고, 하나의 서비스를 개발하고 운영하는 상황에서 각각 어떤 역할을 하는지 살펴본다.

1. 먼저 전체 그림부터 보기

용어중심 질문주요 관심사
DevOps 개발한 기능을 어떻게 안정적으로 전달할까? 개발·운영 협업, 배포 자동화, 피드백
DevSecOps 개발부터 운영까지 보안을 어떻게 통합할까? 보안 검증, 취약점 관리, 책임 공유
AIOps AI로 IT 운영 데이터를 어떻게 분석하고 대응할까? 이상 탐지, 이벤트 연관 분석, 장애 대응
AISecOps AI와 보안 운영을 어떻게 결합할까? AI를 활용한 보안 운영 또는 AI 시스템의 보안 운영

여기서 AISecOps는 사용하는 조직과 자료에 따라 의미가 달라질 수 있다. 어떤 곳은 AI 기반 보안 분석을, 다른 곳은 AI 시스템과 에이전트를 안전하게 운영하는 활동을 강조한다.

따라서 이 용어를 접하면 먼저 “AI로 보안을 하는가, AI 자체를 보호하는가?”를 확인하는 편이 좋다. 실제로 AISecOps Interceptor 프로젝트는 실행하는 AI 시스템의 런타임 거버넌스에 초점을 맞춘다. 이는 해당 프로젝트의 정의로 이해해야 한다.

2. DevOps: 개발과 운영이 서비스의 전체 흐름을 함께 책임진다

개발팀이 기능을 완성해 운영팀에 전달했다고 가정해 보자.

개발 환경에서는 잘 동작했는데 실제 서버에서는 오류가 발생한다. 운영팀은 배포 정보를 충분히 전달받지 못했고, 개발팀은 운영 환경을 정확히 모른다.

이런 단절을 줄이기 위해 개발과 운영의 협업을 강조하는 접근이 DevOps다.

DevOps는 도구와 자동화뿐 아니라 팀이 책임을 공유하고 운영 결과를 개발에 반영하는 방식까지 포함한다. CI/CD는 이를 구현하는 대표적인 수단이다. IBM의 DevOps 설명

예를 들어 다음과 같은 흐름을 만들 수 있다.

코드 변경
   ↓
자동 빌드 및 테스트
   ↓
배포 준비
   ↓
서비스 배포
   ↓
운영 상태 확인
   ↓
다음 변경에 반영

이 글의 예시에서 중요한 변화는 “배포가 끝났다”의 기준이다.

파일을 서버에 올리는 것으로 끝내지 않고, 사용자 요청이 정상적으로 처리되는지까지 확인한다. 문제가 생기면 변경 사항을 추적하고 복구할 수 있어야 한다.

DevOps를 도입할 때는 다음 질문이 유용하다.

  • 동일한 코드를 같은 방식으로 다시 배포할 수 있는가?
  • 어떤 변경이 언제 배포됐는지 추적할 수 있는가?
  • 장애가 생겼을 때 개발팀과 운영팀이 같은 정보를 보는가?
  • 문제가 있는 배포를 되돌릴 수 있는가?

이 질문에 답하는 과정이 도구의 개수보다 중요하다.

3. DevSecOps: 개발과 운영의 흐름에 보안을 통합한다

배포가 빨라지면 보안 검토 방식도 달라져야 한다.

개발이 모두 끝난 뒤 보안팀이 한 번 검토하는 방식으로는, 자주 변경되는 서비스의 위험을 따라가기 어렵다.

DevSecOps는 설계·개발·테스트·배포·운영 전반에 보안을 통합하고, 개발팀·보안팀·운영팀이 책임을 공유하는 접근이다. IBM의 DevSecOps 설명

예시 파이프라인은 다음처럼 확장할 수 있다.

설계 및 위협 검토
   ↓
코드 작성
   ↓
테스트 + 코드·의존성·비밀정보 검사
   ↓
배포 구성 검토
   ↓
정책에 따른 배포
   ↓
운영 중 탐지 및 취약점 대응

여기서 각 검사는 서로 다른 문제를 찾는다.

검사·활동확인하려는 내용
위협 모델링 기능과 설계에서 어떤 악용이 가능한가?
SAST 소스 코드에 보안 결함이 있는가?
SCA 사용하는 라이브러리에 알려진 취약점이 있는가?
비밀정보 검사 API 키나 비밀번호가 코드에 들어갔는가?
IaC 검사 인프라 설정에 위험한 구성이 있는가?
DAST 실행 중인 애플리케이션에서 취약점이 드러나는가?

이 표는 구현 활동을 이해하기 위한 예시다. 모든 조직이 동일한 도구나 순서로 구성해야 한다는 뜻은 아니다.

또한 스캐너를 연결했다고 보안 문제가 자동으로 해결되지는 않는다. 검사 결과를 누가 검토하고, 어떤 기준으로 수정하며, 예외를 언제 재검토할지까지 정해야 실제 업무가 된다.

예를 들어 취약점이 발견됐을 때 다음 정보가 있으면 판단하기 쉽다.

  • 해당 서비스에서 문제가 되는 기능을 실제로 사용하는가?
  • 외부에서 접근할 수 있는가?
  • 수정된 버전이 있는가?
  • 즉시 수정하기 어렵다면 적용할 완화 조치가 있는가?

DevSecOps는 이런 판단을 개발과 운영 흐름 안에서 지속하는 방식으로 이해하면 된다.

4. AIOps: AI를 활용해 IT 운영 데이터를 분석한다

AIOps는 일반적으로 Artificial Intelligence for IT Operations를 의미한다.

로그, 메트릭, 이벤트 등 운영 데이터를 분석해 중요한 이상 신호를 찾고, 연관된 문제를 묶거나 장애 원인 후보를 좁히는 데 AI와 머신러닝을 활용한다. 생성형 AI가 반드시 필요한 개념은 아니다. IBM의 AIOps 설명

여기서 자주 생기는 혼동이 있다.

AIOps의 기본 의미는 ‘AI 모델을 운영하는 일’이 아니라, ‘IT 운영에 AI를 활용하는 일’이다.

예를 들어 쇼핑몰에서 다음 알림이 동시에 발생했다고 하자.

상품 API 응답 지연
결제 API 타임아웃
DB 연결 대기 증가
일부 애플리케이션의 CPU 사용률 상승

담당자는 각각의 알림을 조사해야 한다. 하지만 모두 하나의 문제에서 파생됐을 수도 있다.

AIOps의 대표적인 활용은 이런 이벤트의 시간과 관계를 분석해, 같은 장애와 관련될 가능성이 높은 신호를 모으는 것이다. AIOps의 이벤트 연관 분석

이 사례에서 운영자가 받고 싶은 결과는 다음과 같다.

관측된 현상:
여러 API에서 같은 시간대에 지연 발생

우선 확인할 대상:
DB 연결 대기 증가

추가 확인:
최근 배포와 연결 설정 변경 여부

이 결과는 조사할 가설이다. AI가 원인을 확정했다고 받아들이기보다는 실제 지표와 변경 이력을 확인해야 한다.

실무에서 시도해 볼 만한 적용 범위는 다음과 같다.

  • 반복되는 알림을 묶어 전달하기
  • 장애 관련 로그를 찾아 요약하기
  • 최근 배포와 이상 발생 시점을 비교하기
  • 담당 팀에 조사 자료를 모아 전달하기

처음에는 분석과 추천부터 시작하고, 검증 결과에 따라 자동 조치 범위를 늘리는 구성을 고려할 수 있다.

5. AISecOps: AI로 보안을 운영하는가, AI를 안전하게 운영하는가?

AISecOps를 이해할 때는 두 가지 방향을 나눠 보면 편하다.

이 구분은 이 글에서 혼동을 줄이기 위해 사용하는 설명 방식이다.

5-1. AI를 활용한 보안 운영

첫 번째 방향은 보안 담당자의 분석과 대응에 AI를 활용하는 것이다.

예를 들어 여러 경보를 요약하거나, 의심스러운 활동의 조사 순서를 제안하고, 보안 로그를 조회할 쿼리 작성을 돕는 방식이다.

Microsoft Security Copilot도 사고 대응, 위협 헌팅, 정보 수집, 보안 상태 관리 등을 지원하는 생성형 AI 보안 솔루션으로 설명된다. Microsoft 공식 문서

가상의 계정 침해 조사에서는 다음과 같이 활용할 수 있다.

로그인 및 보안 이벤트 수집
   ↓
AI가 사건의 시간 순서 요약
   ↓
추가 조사 항목 제안
   ↓
담당자가 근거 확인
   ↓
계정 보호 및 대응

AIOps와 데이터 분석 방식이 겹칠 수 있지만, 이 예시의 목표는 보안 사고 조사다.

5-2. AI 시스템 자체의 보안 운영

두 번째 방향은 AI 서비스와 에이전트를 보호하고 통제하는 것이다.

AI 시스템도 일반 소프트웨어와 마찬가지로 접근 통제와 기반 인프라 보안이 필요하다. 여기에 모델, 데이터, 입력과 출력 등 AI와 관련된 위험을 함께 고려해야 한다. NIST도 일반적인 사이버보안 위험과 AI 고유의 위험이 겹친다고 설명한다. NIST의 AI 보안·복원력 설명

특히 에이전트가 외부 도구를 실행하면, 잘못된 판단이 실제 작업으로 이어질 수 있다.

예를 들어 운영 지원 에이전트가 로그를 읽는 권한과 서버 설정을 바꾸는 권한을 모두 가지고 있다고 하자. 외부 입력이나 도구 결과를 잘못 해석하면 의도하지 않은 변경을 시도할 수 있다.

OWASP는 과도한 기능, 권한, 자율성이 결합해 피해를 일으키는 위험을 Excessive Agency로 설명한다. OWASP: Excessive Agency

이런 시스템에서는 다음과 같은 운영 설계를 검토할 수 있다.

  • 에이전트에 업무에 필요한 최소 권한만 부여하기
  • 읽기 작업과 변경 작업의 권한을 구분하기
  • 영향이 큰 작업에는 승인 절차 적용하기
  • 도구 호출의 대상과 인자를 실행 전에 검증하기
  • 실행 기록과 결과를 남기기
  • 작업 횟수·시간·비용에 한도를 설정하기

핵심은 AI의 답변 품질과 함께 실제로 실행할 수 있는 행동의 범위를 관리하는 것이다.

6. 하나의 장애 상황에서 비교해 보기

이제 가상의 쇼핑몰에 결제 기능을 배포했다고 가정해 보자.

DevOps 관점

코드 변경이 테스트와 배포를 거쳐 서비스에 반영된다. 배포 후 결제 성공률과 오류율을 확인하고, 문제가 있으면 복구한다.

관심사는 변경을 전달하고 운영 결과를 반영하는 흐름이다.

DevSecOps 관점

결제 기능의 권한과 데이터 흐름을 검토한다. 코드와 의존성 등을 검사하고, 발견된 위험을 처리한 뒤 배포한다. 운영 중 발견된 취약점도 수정 흐름으로 연결한다.

관심사는 변경 과정과 운영 전반의 보안이다.

AIOps 관점

배포 이후 여러 서비스에서 발생한 알림을 분석한다. 결제 오류와 DB 대기 증가가 함께 발생했다면 관련성을 제시하고 조사할 대상을 좁힌다.

관심사는 운영 데이터에서 문제의 신호를 찾는 일이다.

AI 기반 보안 운영 관점

같은 시간대의 비정상 로그인과 권한 변경을 분석한다. 단순 장애 외에 침해 가능성도 조사한다.

관심사는 위협의 탐지와 조사다.

AI 시스템 보안 운영 관점

조사를 지원하는 에이전트가 어떤 로그를 읽고 어떤 명령을 실행할 수 있는지 통제한다. 결제 서비스 설정을 바꾸는 작업은 별도의 정책으로 검증한다.

관심사는 조사 도구로 사용되는 AI의 행동과 권한이다.

이처럼 하나의 서비스 안에서 여러 접근이 함께 적용될 수 있다.

7. MLOps와 LLMOps는 어디에 해당할까?

AIOps와 함께 자주 등장하는 용어가 MLOps와 LLMOps다.

MLOps는 머신러닝 모델을 실제 환경에서 개발·배포·관리하는 생애주기에 초점을 맞춘다. IBM도 AIOps와 MLOps를 이 기준으로 구분한다. IBM Developer의 Ops 비교

LLMOps는 보통 그중 LLM 기반 시스템의 평가와 운영을 강조할 때 사용한다.

대상을 기준으로 비교하면 이해하기 쉽다.

상황관련 접근
웹서비스를 반복적으로 배포하고 운영 DevOps
배포와 운영 과정에 보안 통합 DevSecOps
AI로 웹서비스의 장애 신호 분석 AIOps
추천 모델을 배포하고 성능 관리 MLOps
LLM 앱의 프롬프트·모델 변경을 평가하고 운영 LLMOps
AI로 보안 경보 조사 지원 AI 기반 보안 운영
AI 에이전트의 권한과 실행 통제 AI 보안 운영

실제 조직에서는 이 업무들이 겹친다. 추천 모델을 배포하는 팀도 DevSecOps를 적용할 수 있고, LLM 서비스의 장애를 AIOps 도구로 분석할 수도 있다.

8. 우리 팀은 어디서부터 시작하면 좋을까?

도입 방향을 정할 때는 팀에서 반복되는 문제를 먼저 적어 보는 것을 권한다.

반복되는 문제우선 검토할 개선
배포할 때마다 담당자와 절차가 달라진다 배포 자동화와 책임 정리
보안 검토가 출시 직전에 몰린다 개발 단계부터 보안 활동 통합
알림이 너무 많아 중요한 장애를 놓친다 관측 데이터 정리와 이벤트 분석
보안 사고 조사에 자료 수집 시간이 오래 걸린다 AI를 활용한 조사 보조
AI 에이전트의 실행 범위를 설명하기 어렵다 권한·정책·실행 기록 정비

이 표는 도입을 위한 제안이다. AI를 적용하기 전에 데이터와 책임 범위가 정리돼 있는지도 함께 살펴봐야 한다.

서비스 이름이 시스템마다 다르고, 변경 이력이 남지 않으며, 담당자 정보도 없다면 AI 분석 결과를 검증하기 어렵다. 에이전트가 어떤 권한으로 작업하는지 모른다면 자동화 범위를 넓히기도 어렵다.

작게 시작하는 방법은 다음과 같다.

  1. 반복되는 업무 하나를 선택한다.
  2. 필요한 데이터와 담당자를 정한다.
  3. 현재 걸리는 시간과 오류를 기록한다.
  4. 자동화 또는 AI 보조를 적용한다.
  5. 절약한 시간과 잘못된 결과를 함께 평가한다.
  6. 검증된 범위부터 확대한다.

“AI를 도입했다”보다 “장애 조사에 필요한 자료를 모으는 시간이 줄었다”처럼 구체적인 결과를 확인하는 편이 유용하다.

9. 성과는 어떤 지표로 확인할까?

이 글에서 제안하는 평가 예시는 다음과 같다.

영역살펴볼 지표
개발·배포 변경 전달 시간, 배포 실패, 복구 시간
보안 통합 취약점 수정 시간, 미처리 예외, 운영에서 발견된 결함
AI 기반 운영 분석 유효 알림 비율, 원인 조사 시간, 잘못된 추천
AI 기반 보안 조사 경보 분류 시간, 조사 정확도, 오탐과 미탐
AI 실행 통제 정책 위반, 비인가 실행, 기록 누락, 한도 초과

속도와 정확도를 함께 봐야 한다.

알림을 줄였지만 중요한 장애까지 숨겼다면 개선으로 보기 어렵다. 조사 보고서를 빨리 만들었어도 근거가 틀렸다면 검토 부담이 늘어난다. 에이전트의 작업 성공률이 높아도 허용 범위를 벗어났다면 통제를 다시 살펴봐야 한다.

팀이 원하는 결과를 먼저 정의해야 지표도 의미가 생긴다.

마치며

DevOps는 개발과 운영을 연결하고, DevSecOps는 그 흐름에 보안을 통합한다. AIOps는 운영 데이터를 분석하는 데 AI를 활용한다.

AISecOps는 자료마다 강조점이 다르므로 적용 범위를 확인해야 한다. 이 글에서는 AI를 활용한 보안 운영과 AI 시스템 자체의 보안 운영으로 나누어 살펴봤다.

앞으로 에이전트가 더 많은 도구를 실행하게 되면, 분석 결과를 검토하는 일과 실행 권한을 관리하는 일이 모두 중요해질 것이다.

새로운 용어를 도입할 때 우리 팀이 먼저 답해야 할 질문도 구체적이다.

어떤 업무를 개선하려는가? 어떤 근거로 효과를 확인할 것인가? 자동화에는 어디까지 권한을 줄 것인가?

AI 에이전트가 데이터베이스 검색부터 단백질 구조 분석까지 연결한다면, 연구 과정은 어떻게 달라질까?


Google DeepMind가 Antigravity를 활용한 항균 펩타이드 후보 발굴 과정을 공개했다.

IT 관점에서 주목할 부분은 연구자가 여러 전문 도구를 오가며 수행하던 작업을 에이전트와의 대화로 연결했다는 점이다. 원문

무엇을 찾는 연구일까?

항균 펩타이드(AMP)는 세균을 억제하는 물질이다. 항생제 내성에 대응할 새로운 치료제 후보로 연구되고 있다.

단백질 데이터베이스에는 서열은 등록됐지만 기능이 밝혀지지 않은 항목이 많다. 이번 사례에서는 아미노산 서열로 단백질 기능을 예측하는 ProtNLM을 활용해 탐색했다.

후보는 어떻게 좁혔을까?

전체 흐름은 다음과 같다.

UniProt에서 후보 탐색
        ↓
기존 단백질과 서열 비교
        ↓
예측 구조와 실험 구조 비교
        ↓
주변 유전자 분석
        ↓
문헌 검토와 실험 계획 수립

하나의 예측만으로 결론을 내리지 않고, 서열·구조·유전자 맥락에서 얻은 근거를 쌓는 방식이다. 연구자는 분석 방향을 정하고, 에이전트는 데이터 수집과 도구 실행을 담당했다. 발굴 과정

Antigravity와 ProtNLM의 역할

구성 요소역할
Antigravity 연구자와 에이전트가 분석을 진행하는 작업 공간
ProtNLM 단백질 서열을 바탕으로 기능 예측
내장 3D 뷰어 단백질 구조를 함께 살펴보는 인터페이스

특히 3D 뷰어에서는 연구자가 표시한 구조 영역이 에이전트에도 전달된다. 텍스트뿐 아니라 같은 시각적 맥락을 공유하는 협업이다. 기능 설명

아직은 ‘후보’ 단계

발굴된 물질은 실험 검증 중이다. 실제 항균 효과나 치료제로서의 유효성이 확인됐다는 뜻은 아니다. 검증 상태

개발자 관점에서 본 의미

개인적으로는 전문 모델과 여러 도구를 연결하는 에이전트의 역할이 흥미롭다.

개발자가 에이전트에 코드 검색과 실행을 맡기듯, 연구자도 데이터 탐색과 분석을 맡기고 근거를 검토한다. 이런 협업이 실제 발견으로 이어지는지는 후속 실험 결과를 지켜볼 필요가 있다.


참고한 원문

Accelerating the search for antimicrobial peptides with Google Antigravity — Google DeepMind

기업이 생성형 AI를 도입할 때 가장 먼저 비교하는 것은 모델의 성능과 가격이다. 그러나 금융, 공공, 의료와 같은 분야에서는 또 다른 질문이 중요하다.

“우리의 데이터는 어디에 저장되고, 누구의 법률과 통제를 받는가?”

AI가 국가 경제와 기업 운영의 핵심 기반으로 자리 잡으면서 소버린 AI(Sovereign AI)와 데이터 주권이 중요한 IT 전략으로 떠오르고 있다.

소버린 AI란 무엇인가

소버린 AI는 국가 또는 조직이 자국의 법률, 문화, 언어와 정책에 따라 AI 모델과 데이터, 인프라를 통제할 수 있는 역량을 의미한다.

단순히 국내 기업이 만든 AI 모델만을 뜻하지는 않는다. 다음과 같은 요소를 종합적으로 살펴봐야 한다.

  • 데이터가 저장되고 처리되는 위치
  • 모델과 클라우드 인프라의 운영 주체
  • 적용되는 법률과 규제
  • 학습 데이터와 모델에 대한 접근 권한
  • 서비스 중단 시 대체 가능성
  • 국가 언어와 문화적 맥락의 반영
  • 반도체와 데이터센터를 포함한 공급망

해외 모델을 사용하더라도 데이터 처리와 암호키, 운영 권한을 국내에서 통제한다면 소버린 AI 전략의 일부가 될 수 있다. 반대로 국내 서비스라도 핵심 모델과 인프라를 외부 사업자에 전적으로 의존한다면 완전한 통제력을 확보했다고 보기 어렵다.

데이터 주권과 데이터 현지화의 차이

두 개념은 비슷해 보이지만 동일하지 않다.

데이터 현지화는 데이터를 특정 국가 또는 지역 안에 저장하고 처리하도록 요구하는 것이다. 저장 위치에 초점을 둔다.

데이터 주권은 데이터가 어느 국가의 법률과 통제를 받는지를 의미한다. 데이터가 국내 데이터센터에 있더라도 해외 사업자의 운영 정책이나 외국 법률의 영향을 받는다면 주권 문제가 남을 수 있다.

따라서 기업은 데이터센터 위치만 확인해서는 안 된다. 운영자의 접근 권한, 암호키 관리, 백업 위치, 장애 대응과 정부의 정보 제공 요구 가능성까지 검토해야 한다.

왜 지금 중요해졌는가

기존 클라우드에서도 데이터 주권은 중요한 문제였다. 생성형 AI 시대에는 모델이 기업의 핵심 데이터와 업무 판단에 직접 관여하면서 영향이 더 커졌다.

AI 에이전트는 다음과 같은 정보에 접근할 수 있다.

  • 고객과 임직원의 개인정보
  • 기업의 계약서와 내부 규정
  • 재무·신용·거래정보
  • 소스코드와 기술문서
  • 의료기록과 상담 내용
  • 경영진의 의사결정 자료

이 데이터가 어느 환경에서 처리되는지, 모델 학습에 다시 사용되는지, 서비스 사업자가 어느 범위까지 접근할 수 있는지를 알 수 없다면 핵심 업무를 맡기기 어렵다.

Gartner는 2026년 주요 데이터·분석 트렌드의 첫 번째로 소버린 AI의 가속을 제시했다. 각국이 외부 국가에 대한 의존을 줄이고 AI 역량과 데이터 통제권을 확보하려는 움직임이 기업의 AI 로드맵에도 영향을 준다는 설명이다.

참고: Gartner, Top Trends for Data and Analytics 2026

소버린 AI가 중요한 산업

금융

금융회사는 신용정보와 거래정보를 처리하며 모델의 판단이 대출, 투자와 이상거래 탐지에 영향을 줄 수 있다. 데이터의 국외 이전, 외부 위탁, 설명 가능성과 감사 기록을 함께 관리해야 한다.

공공

행정, 국방과 국가 기반시설의 데이터는 외부 서비스 중단이나 정책 변경에 따라 사용할 수 없게 되는 상황을 피해야 한다. 국가 언어와 법률을 정확하게 반영하는 것도 중요하다.

의료

진료기록과 유전체 데이터는 유출됐을 때 되돌릴 수 없는 민감정보다. 저장 위치뿐 아니라 추론 과정에서의 데이터 전송과 모델 사업자의 접근 가능성을 확인해야 한다.

제조와 연구개발

설계도, 생산공정과 연구자료는 기업 경쟁력의 핵심이다. 외부 AI를 통한 지식재산 유출 가능성과 공급망 의존을 고려해야 한다.

모든 AI를 자체 구축해야 할까

소버린 AI가 반드시 모든 모델과 데이터센터를 직접 만들어야 한다는 뜻은 아니다. 자체 구축은 통제력을 높일 수 있지만 비용과 운영 난도가 크다.

기업은 업무의 위험 수준에 따라 다양한 방식을 조합할 수 있다.

업무 유형 가능한 운영 방식

공개 자료 요약 외부 상용 AI 서비스
일반 사내 문서 기업용 격리 환경과 클라우드 모델
개인정보·거래정보 국내 리전 또는 전용 환경
핵심 기술·국가 기밀 온프레미스 또는 완전 통제 환경

중요한 것은 하나의 모델로 모든 업무를 처리하는 것이 아니라 데이터의 민감도, 업무 위험과 비용에 따라 적절한 모델을 선택하는 멀티모델 전략이다.

소버린 AI의 현실적인 과제

통제력을 높이면 새로운 비용과 문제가 발생한다.

  • 데이터센터와 AI 가속기 확보 비용
  • 최신 모델을 지속적으로 개선할 인력 부족
  • 글로벌 대형 모델과의 성능 격차
  • 국내 데이터만 사용했을 때의 다양성 부족
  • 여러 모델과 환경을 운영하는 복잡성
  • 자체 구축 시스템의 보안 책임 증가

자체 환경이라는 이유만으로 자동으로 안전해지는 것은 아니다. 보안 업데이트와 접근 통제를 제대로 운영하지 못하면 외부 클라우드보다 위험할 수도 있다.

기업이 확인해야 할 질문

AI 서비스를 도입할 때 다음 항목을 확인할 필요가 있다.

  1. 입력 데이터와 결과는 어느 국가에 저장되는가?
  2. 데이터 처리에는 어느 국가의 법률이 적용되는가?
  3. 서비스 사업자가 입력 내용을 모델 학습에 사용하는가?
  4. 운영자도 읽을 수 없도록 기업이 암호키를 통제할 수 있는가?
  5. 데이터와 로그의 보관 기간을 설정할 수 있는가?
  6. 계약 종료 시 데이터와 모델 자산을 이전할 수 있는가?
  7. 서비스가 중단되면 다른 모델로 전환할 수 있는가?
  8. AI가 내린 결정과 사용 데이터를 감사할 수 있는가?

이 질문에 답하지 못한다면 모델의 정확도가 높더라도 핵심 업무에 적용하기 어렵다.

마치며

소버린 AI는 국내 모델과 해외 모델 중 하나를 선택하는 단순한 문제가 아니다. 기업과 국가가 데이터, 모델, 인프라와 운영 정책을 어느 수준까지 통제할 것인지 결정하는 전략이다.

앞으로 AI 경쟁력은 가장 뛰어난 모델을 사용하는 것만으로 결정되지 않을 수 있다. 필요한 데이터를 안전하게 활용하고, 특정 공급자나 국가에 대한 의존을 관리하며, 환경 변화에도 서비스를 계속 운영할 수 있는 능력이 함께 필요하다.

AI 시대의 주권은 데이터를 국내에 보관하는 데서 끝나지 않는다. 누가 접근하고, 어떤 규칙으로 처리하며, 필요할 때 다른 선택으로 전환할 수 있는가까지 포함한다.

기존 챗봇이 잘못된 답변을 생성하면 사용자는 답변을 무시하고 다시 질문할 수 있었다. 그러나 AI 에이전트가 이메일을 보내고, 주문을 취소하고, 데이터베이스를 수정한다면 잘못된 판단이 실제 업무의 오류로 이어진다.

이때 필요한 것이 AI 에이전트 옵저버빌리티(Agent Observability)다. 에이전트가 어떤 판단 과정을 거쳐 무엇을 실행했는지 관찰하고 추적하는 체계다.

모니터링과 옵저버빌리티는 무엇이 다른가

전통적인 모니터링은 미리 정한 지표를 확인한다. 서버의 CPU 사용률, 응답시간, 오류율이 대표적이다. 문제가 무엇인지 이미 어느 정도 알고 있을 때 효과적이다.

옵저버빌리티는 로그, 메트릭, 트레이스 등 시스템이 남긴 정보를 바탕으로 예상하지 못한 문제의 원인을 파악하는 데 초점을 둔다.

AI 에이전트는 같은 요청에도 검색 결과, 모델 응답, 사용 가능한 도구와 이전 대화에 따라 다른 경로를 선택할 수 있다. 최종 응답만 저장해서는 왜 그런 결과가 나왔는지 알기 어렵다.

에이전트 트레이스란 무엇인가

에이전트 트레이스는 하나의 요청이 완료될 때까지 수행된 전체 과정을 연결한 기록이다.

고객 환불 업무라면 다음 내용이 포함될 수 있다.

  1. 사용자가 입력한 요청
  2. 에이전트가 세운 작업 계획
  3. 검색한 환불 규정과 문서 버전
  4. 주문 시스템에 전달한 조회 조건
  5. 다른 에이전트에 위임한 작업
  6. 각 단계에서 사용한 모델과 프롬프트
  7. 사람에게 승인을 요청한 시점
  8. 실제 환불 API 호출과 결과

이 기록이 연결돼야 “잘못된 문서를 검색했는지”, “규칙은 맞았지만 도구가 실패했는지”, “사용자 승인 범위를 넘었는지”를 구분할 수 있다.

일반 애플리케이션보다 관찰하기 어려운 이유

전통적인 프로그램은 정해진 조건에 따라 비교적 예측 가능한 경로로 동작한다. 반면 AI 에이전트는 자연어를 해석하고 다음 행동을 동적으로 선택한다.

오류의 원인도 다양하다.

  • 사용자의 지시가 모호함
  • 검색 문서가 오래되거나 잘못됨
  • 모델이 도구의 용도를 잘못 이해함
  • 다른 에이전트의 응답이 부정확함
  • API는 성공했지만 업무 결과는 잘못됨
  • 지나치게 많은 반복 호출로 비용 증가
  • 중간 단계에서 오류가 발생했지만 작업은 계속 진행됨

HTTP 응답이 200이라는 사실만으로 업무가 정상적으로 완료됐다고 판단할 수 없는 이유다.

무엇을 측정해야 하는가

에이전트의 성능은 단순한 답변 정확도만으로 평가하기 어렵다. 실제 운영에서는 다음과 같은 지표가 필요하다.

업무 품질

  • 목표 완료율
  • 올바른 도구 선택 비율
  • 잘못된 실행과 실행 취소 비율
  • 사람의 수정 없이 완료된 비율
  • 정책과 업무 규칙 위반 건수

운영 효율

  • 업무당 모델 호출 횟수
  • 평균 토큰과 비용
  • 완료까지 걸린 시간
  • 같은 작업을 반복한 횟수
  • 외부 도구와 API의 실패율

인간 개입

  • 승인 요청 비율
  • 담당자가 결정을 변경한 비율
  • 에이전트에서 사람에게 이관된 비율
  • 사람이 개입하기까지 걸린 시간

지표는 업무의 위험 수준에 따라 달라져야 한다. 회의록 작성 에이전트와 결제 에이전트에 동일한 성공 기준을 적용할 수는 없다.

관찰에서 자동 대응으로

옵저버빌리티의 목적은 보고서를 만드는 데 그치지 않는다. 위험한 행동을 발견하면 실행을 중단하거나 사람에게 전달할 수 있어야 한다.

예를 들어 다음과 같은 정책을 적용할 수 있다.

  • 동일 API를 일정 횟수 이상 호출하면 작업 중지
  • 승인 한도를 넘는 결제는 담당자에게 이관
  • 신뢰도가 낮은 문서만 검색되면 답변 생성 중단
  • 개인정보가 포함된 입력은 외부 모델로 전송 금지
  • 평소와 다른 도구 호출 순서가 나타나면 경고
  • 에이전트 간 반복 위임이 발생하면 루프 차단

이 구조는 관찰, 판단, 통제가 하나의 운영 체계로 연결돼야 효과가 있다.

모든 내용을 기록하면 안전할까

상세한 로그는 문제 분석에 도움이 되지만 새로운 보안 위험을 만들 수도 있다. 프롬프트와 도구의 응답에는 개인정보, 계약정보, 인증 토큰과 사내 기밀이 포함될 수 있기 때문이다.

따라서 기록 단계에서도 다음 원칙이 필요하다.

  • 민감정보 마스킹과 비식별화
  • 로그 접근 권한 최소화
  • 업무별 보관 기간 설정
  • 원문과 요약 기록의 분리
  • 위변조 방지와 감사 이력 관리
  • 외부 관측 도구로 전송할 데이터 제한

많이 저장하는 것이 항상 좋은 옵저버빌리티는 아니다. 문제를 재현할 수 있을 만큼 기록하되 불필요한 민감정보는 남기지 않아야 한다.

기업이 도입할 때 확인할 사항

  1. 사용자 요청부터 최종 실행까지 하나의 트레이스로 연결되는가?
  2. 모델, 프롬프트, 검색 문서의 버전을 확인할 수 있는가?
  3. 에이전트 간 위임과 도구 호출을 함께 추적할 수 있는가?
  4. 기술적 성공과 업무적 성공을 구분하는가?
  5. 이상 행동이 발생하면 자동으로 중단할 수 있는가?
  6. 사고 발생 후 동일 조건을 재현할 수 있는가?
  7. 기록에 포함된 개인정보와 기밀을 보호하는가?

Gartner는 AI를 배포한 조직 중 40%가 2028년까지 모델 성능을 관리하기 위해 AI 옵저버빌리티를 사용할 것으로 전망했다. 동시에 에이전틱 AI가 분석에서 실제 조치로 이어지려면 기술뿐 아니라 사람, 프로세스와 거버넌스의 변화가 필요하다고 설명했다.

참고: Gartner, AI Infrastructure and Observability Trends

마치며

AI 에이전트 운영에서 중요한 것은 최종 답변만 확인하는 것이 아니다. 어떤 정보를 참고했고, 어떤 판단을 내렸으며, 무엇을 실행했는지 전체 흐름을 볼 수 있어야 한다.

에이전트 옵저버빌리티는 단순한 로그 수집 기술이 아니다. AI의 행동을 설명하고, 비용을 관리하며, 사고를 중단하고, 책임 소재를 확인하기 위한 운영 기반이다.

AI 에이전트에 더 많은 자율성을 부여할수록 조직은 그 행동을 더 투명하게 관찰할 수 있어야 한다.

+ Recent posts